
 Da Manlio Carlo Soldani
Indice dei contenuti
Il problema che nessuno ha risolto davvero finora
C’è una contraddizione che attraversa l’adozione dell’intelligenza artificiale nelle professioni intellettuali avanzate, e che pochi analisti hanno sintetizzato con chiarezza: i sistemi AI più sofisticati — quelli capaci di ragionare su documenti complessi, supportare la ricerca, generare bozze, rispondere a interrogazioni in linguaggio naturale — operano su dati testuali. Il mondo reale delle professioni, invece, è multimodale per definizione.
Un avvocato che istruisce una causa lavora su fascicoli che contengono atti processuali in PDF, fotografie di eventi rilevanti, registrazioni audio di deposizioni, video di sopralluogo, perizie che integrano testo e grafico, estratti conto in forma tabellare, messaggi di posta elettronica, planimetrie. Un medico formula una diagnosi incrociando anamnesi scritta, referti di laboratorio, immagini diagnostiche — radiografie, TAC, RMN, ecografie — audiogrammi, dati di monitoraggio strumentale, note di reparto in forma narrativa. Un ingegnere strutturista valuta un immobile attraverso relazioni tecniche, fotografie di sopralluogo, rilievi planoaltimetrici, schede dei materiali, risultati di prove di carico in forma numerica, video di ispezione endoscopica, estratti cartografici. Un notaio affronta ogni giorno documentazione eterogenea che comprende atti in formato misto, visure catastali, planimetrie, fotografie di stati di conservazione, documenti identità in formato immagine, relazioni bancarie.
Questa eterogeneità non è un’eccezione né un residuo di pratiche antiquate. È la natura intrinseca dell’informazione professionale, che riflette la complessità del mondo fisico e giuridico su cui le professioni operano.
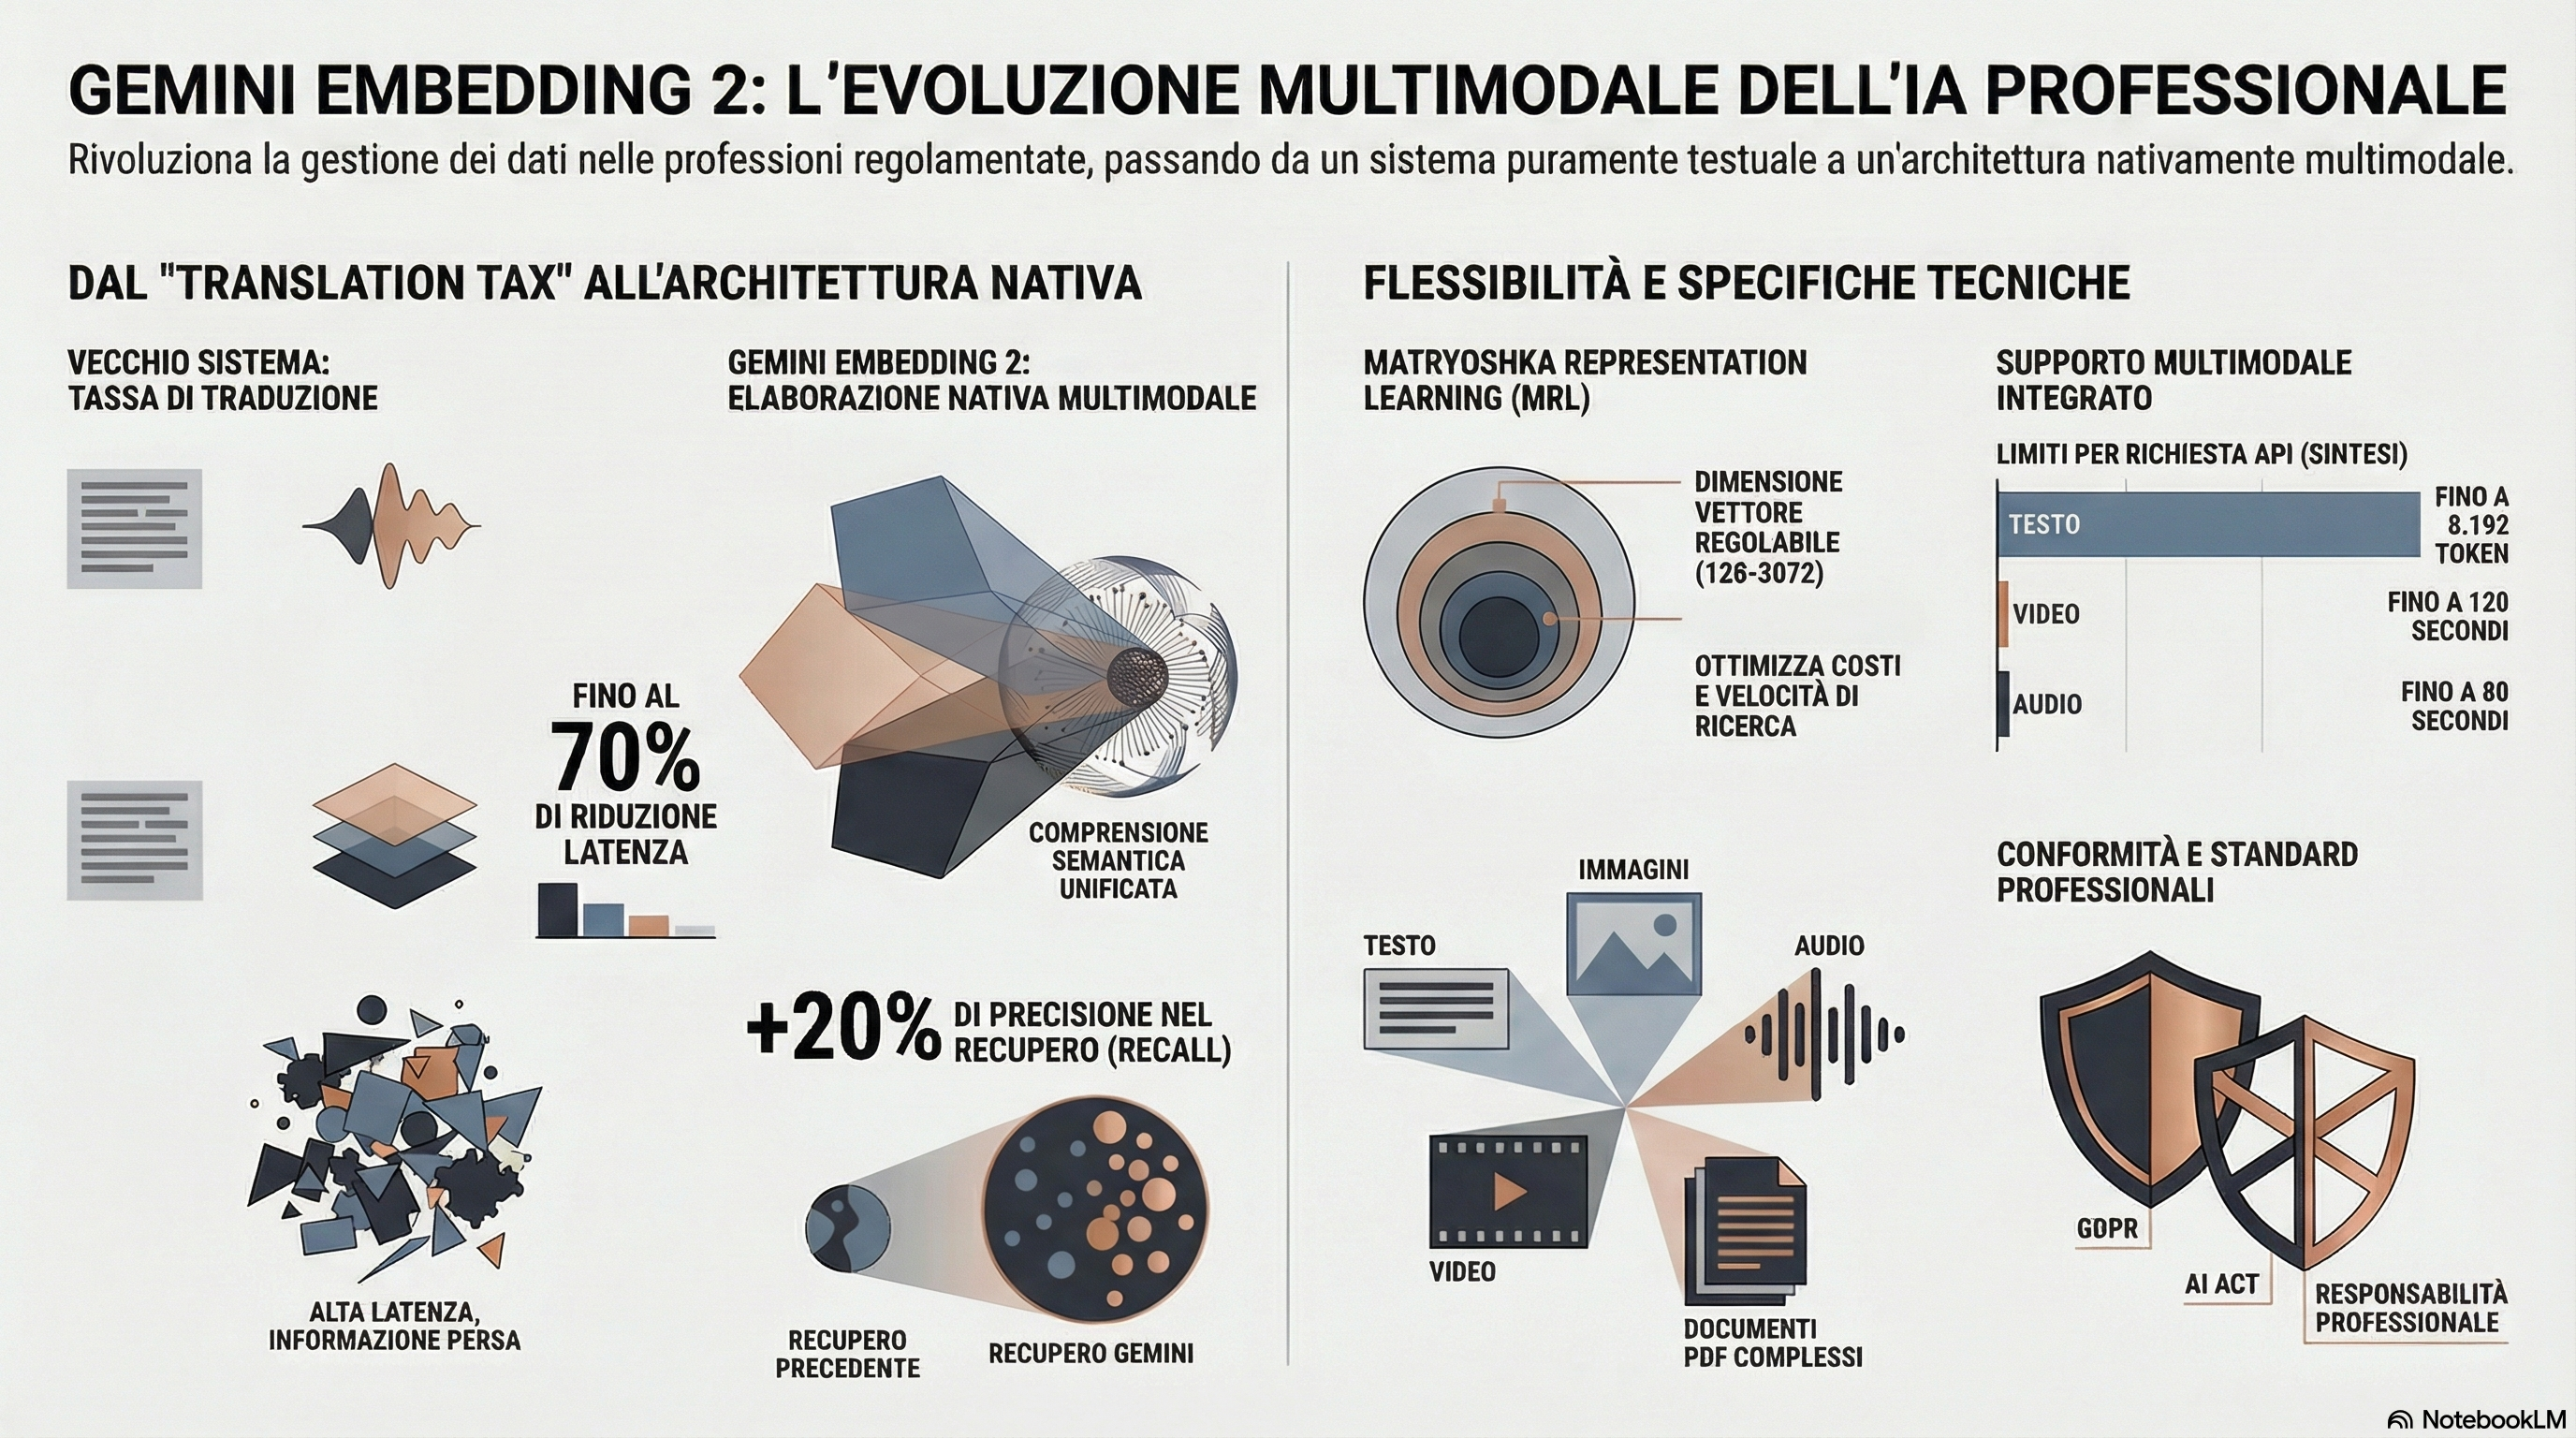
L’intelligenza artificiale della prima generazione — i grandi modelli linguistici, i sistemi di ricerca semantica basati su embedding testuali — ha affrontato questo problema con soluzioni parziali: estrarre il testo dai PDF, trascrivere l’audio, generare descrizioni testuali delle immagini, per poi elaborare tutto come se fosse testo. Ogni passaggio intermedio introduce perdita di informazione, errori di trascrizione, latenza computazionale, e — soprattutto — la perdita delle relazioni semantiche che esistono tra modalità diverse: il rapporto tra una fotografia e la nota scritta che la commenta, tra un grafico e il paragrafo del testo che lo interpreta, tra un’immagine diagnostica e il referto che la accompagna.
Il rilascio di Gemini Embedding 2 da parte di Google DeepMind il 10 marzo 2026 affronta questo problema alla radice. Non con una soluzione nuova aggiunta sopra alle vecchie architetture, ma con un diverso modo di concepire la rappresentazione dell’informazione. Vale la pena capirne la struttura in profondità, perché le implicazioni per chi lavora con archivi documentali eterogenei sono più sostanziali di quanto la comunicazione di marketing tenda a suggerire.
Cos’è un embedding e perché è la tecnologia fondamentale — non i chatbot
Il dibattito pubblico sull’intelligenza artificiale è dominato dai modelli generativi: i sistemi che producono testo, immagini, codice. ChatGPT, Claude, Gemini nella sua accezione conversazionale, Midjourney. Questi strumenti sono visibili, interattivi, immediatamente comprensibili nell’utilizzo. Tendono quindi a catalizzare l’attenzione.
Gli embedding model sono meno visibili — non generano nulla da mostrare direttamente — ma costituiscono lo strato infrastrutturale che determina se un sistema AI è in grado di trovare le informazioni giuste prima di elaborarle. Sono la fondamenta, non la facciata.
Un modello di embedding riceve in input un contenuto — un paragrafo, una fotografia, un estratto audio, un documento — e restituisce un vettore numerico ad alta dimensionalità. Questo vettore non è una trascrizione del contenuto: è una codifica della sua posizione semantica in uno spazio matematico. La proprietà fondamentale è la seguente: contenuti concettualmente simili producono vettori vicini in questo spazio; contenuti non correlati producono vettori distanti. La vicinanza è misurabile con metriche geometriche standard (tipicamente la similarità coseno).
Questo meccanismo è alla base di tutti i sistemi di ricerca semantica — quelli che restituiscono risultati pertinenti anche quando la query non contiene le stesse parole del documento cercato — e dei sistemi RAG (Retrieval-Augmented Generation), ossia gli assistenti AI che, prima di rispondere, recuperano dinamicamente i frammenti di conoscenza rilevanti da una base documentale proprietaria. In questi sistemi, la qualità del modello di embedding determina la qualità del recupero informativo, che a sua volta determina la qualità della risposta generata. Un modello generativo eccellente accoppiato a un sistema di recupero mediocre produce comunque risposte mediocri o errate.
La storia degli embedding è relativamente lunga nell’informatica: le radici teoriche risalgono agli anni Cinquanta, con i linguisti che studiavano la distribuzione delle parole nei contesti. La svolta pratica moderna è Word2Vec, rilasciato da un team Google guidato da Tomas Mikolov nel 2013. Ma per anni gli embedding hanno riguardato quasi esclusivamente il testo. Il problema di rappresentare immagini, audio e video nello stesso spazio vettoriale del testo — in modo da poter confrontare e recuperare contenuti di modalità diverse con un’unica query — è rimasto un problema aperto, o almeno risolto solo parzialmente.
La storia degli approcci multimodali: perché le soluzioni precedenti erano insufficienti
Prima di Gemini Embedding 2, esistevano approcci per la ricerca cross-modale, ma nessuno li affrontava in modo strutturalmente soddisfacente.
Il più diffuso era l’approccio basato su CLIP (Contrastive Language-Image Pre-Training), sviluppato da OpenAI nel 2021. CLIP addestrava separatamente un encoder testuale e un encoder visivo, e poi li allineava tramite apprendimento contrastivo: le coppie testo-immagine semanticamente correlate venivano avvicinate nello spazio vettoriale, quelle non correlate venivano allontanate. Il risultato era uno spazio condiviso in cui una query testuale poteva recuperare immagini semanticamente affini. Un passo significativo — ma con limiti strutturali evidenti.
Il problema fondamentale di CLIP e degli approcci analoghi è quello che i ricercatori chiamano late fusion: le due modalità vengono elaborate separatamente fino all’ultimo momento, e poi allineate al livello dell’output. L’allineamento avviene dopo che ciascun encoder ha già estratto le rappresentazioni interne dal proprio input, senza che le due modalità abbiano interagito durante l’elaborazione. Questo significa che le relazioni semantiche che emergono quando testo e immagine vengono elaborati insieme — il tipo di comprensione cross-modale che si forma negli strati intermedi di un modello — vengono perse.
Per le applicazioni audio e video, la situazione era ancora più problematica. I sistemi tipici richiedevano passaggi intermedi: trascrivere l’audio in testo con sistemi come Whisper, generare descrizioni testuali dei frame video con modelli di visione, e solo poi embeddarli come testo. Ogni passaggio intermedio è una fonte di errori: l’audio non testuale (rumori, toni, prosodia) viene perso nella trascrizione; i dettagli visivi non verbalizzabili scompaiono nelle descrizioni generate. E ogni passaggio intermedio aggiunge latenza e costo computazionale.
Infine, i sistemi che gestivano modalità diverse producevano vettori in spazi vettoriali non compatibili: il vettore di un testo prodotto da un modello testuale e il vettore di un’immagine prodotto da un modello visivo vivevano in universi matematici separati e non confrontabili. Effettuare una ricerca cross-modale richiedeva costruire infrastrutture ad hoc per “tradurre” o “allineare” vettori provenienti da spazi diversi — soluzioni fragili, costose da mantenere, e con qualità degradata rispetto a un sistema nativo.
Gemini Embedding 2: architettura nativa e cosa cambia davvero
Gemini Embedding 2 è costruito sull’architettura Gemini — lo stesso backbone che alimenta i modelli generativi di Google DeepMind — e addestrato sin dall’origine per trattare tutte le modalità attraverso lo stesso transformer unificato. Non c’è un encoder testuale e un encoder visivo che vengono allineati: c’è un unico modello che comprende testo, immagini, audio e video nello stesso modo in cui li comprende l’architettura su cui è stato addestrato.
Questo cambia la natura stessa della rappresentazione multimodale. Il modello non impara che “una fotografia di un cane” e “le parole golden retriever” sono vicine perché qualcuno gliel’ha detto esplicitamente durante il fine-tuning di allineamento. Le impara perché durante l’addestramento ha elaborato miliardi di esempi in cui le due cose compaiono in contesti sovrapposti, e ha sviluppato rappresentazioni interne che catturano questa relazione strutturalmente. La comprensione cross-modale non è il risultato di un’operazione di mapping aggiuntiva: è intrinseca all’architettura.
La conseguenza pratica più importante è questa: quando si invia al modello una richiesta contenente sia un’immagine che testo — per esempio, una fotografia di un componente meccanico insieme alla domanda “quali sono i requisiti di manutenzione per questo elemento?” — il modello non elabora le due componenti separatamente e poi combina i risultati. Le elabora come un concetto unico, cogliendo la relazione semantica tra il contenuto visivo e il contenuto testuale nell’atto stesso dell’elaborazione. Questo è ciò che la documentazione tecnica di Google chiama input interleaved: una singola chiamata API può ricevere un mix di modalità e restituire un embedding unico che rappresenta il significato complessivo dell’input composito.
Le specifiche tecniche per chi deve prendere decisioni infrastrutturali:
Modalità supportate e limiti per richiesta:
- Testo: fino a 8.192 token (una finestra significativamente più ampia della maggior parte dei modelli precedenti, con implicazioni importanti per la chunking strategy nei sistemi RAG)
- Immagini: fino a 6 per richiesta, formati PNG e JPEG
- Video: fino a 120 secondi per richiesta, formati MP4 e MOV
- Audio: fino a 80 secondi per richiesta, elaborato nativamente senza trascrizione intermedia
- Documenti PDF: fino a 6 pagine per richiesta, con comprensione sia del layout visivo che del contenuto testuale
Dimensionalità: vettori a 3.072 dimensioni come default, con supporto per Matryoshka Representation Learning (MRL).
Benchmark: Sul MTEB English (il benchmark di riferimento per i modelli di embedding testuali), Gemini Embedding 2 raggiunge un punteggio di 68,32, con un margine di 5,09 punti sul secondo classificato. Sui benchmark di video retrieval (Vatex, MSR-VTT, Youcook2) segna 68,8, contro 60,3 di Amazon Nova 2 e 55,2 di Voyage Multimodal 3.5. In termini di competitive positioning, è il primo modello di un grande provider commerciale a coprire nativamente tutte e cinque le modalità (testo, immagini, video, audio, PDF) in un unico spazio vettoriale: OpenAI text-embedding-3 copre solo il testo; Cohere Embed v4 ha aggiunto supporto per le immagini ma non audio e video; nessun altro sistema oggi gestisce video e audio natively attraverso la stessa API.
Lingue: oltre 100, con copertura multilingue estesa.
Integrazione ecosistema: LangChain, LlamaIndex, Haystack, Weaviate, Qdrant, ChromaDB, Pinecone, Vector Search. Per chi già costruisce su questi framework, l’integrazione non richiede riscritture architetturali.
Prezzi: $0,25 per milione di token per testo, immagini e video; $0,50 per milione di token per audio. Tier gratuito disponibile per sviluppo e prototipazione (circa 60 richieste al minuto). La Batch API offre uno sconto del 50% per workload non latency-sensitive.
Matryoshka Representation Learning: flessibilità dimensionale senza riaddestrare
Vale la pena approfondire la tecnica MRL perché ha implicazioni concrete per le decisioni di progettazione infrastrutturale, soprattutto quando si tratta di corpus di grandi dimensioni.
L’idea alla base è che le dimensioni di un vettore di embedding non abbiano tutte lo stesso peso informativo. Nelle prime dimensioni si concentra l’informazione semantica più rilevante e robusta; nelle dimensioni successive si aggiunge progressivamente dettaglio e sfumatura. Addestrand il modello con questa struttura “a matrioska”, è possibile troncare i vettori a dimensioni inferiori — 768, 512, 256, 128 — senza riaddestrare il modello e con una perdita di qualità relativamente contenuta e controllabile.
Le implicazioni pratiche sono significative. Gemini Embedding 2 supporta dimensioni da 128 fino a 3.072. I benchmark mostrano che i punteggi MTEB variano tra 67,99 e 68,17 passando da 768 a 3.072 dimensioni — una differenza marginale in termini di qualità assoluta, ma con un impatto molto diverso su costo di storage e velocità di ricerca.
Per un archivio professionale di grandi dimensioni — un corpus di centomila documenti indicizzati — la scelta della dimensionalità ha effetti diretti sui costi operativi. Un vettore a 768 dimensioni occupa un quarto dello spazio di uno a 3.072 dimensioni e la ricerca di similarità è corrispondentemente più veloce. Questo rende possibile un’architettura a due stadi: una fase di pre-filtraggio rapida su vettori a bassa dimensionalità, seguita da una fase di re-ranking di precisione sui soli candidati selezionati, usando i vettori completi. È la stessa logica che i motori di ricerca moderni usano per scalare su miliardi di documenti.
Il “translation tax” e perché rimuoverlo ha conseguenze reali
La metafora del “translation tax” — la tassa di traduzione — è stata usata dai tecnici di Google DeepMind per descrivere il costo delle pipeline multimodali di precedente generazione. È una metafora precisa che vale la pena articolare perché chiarisce i vantaggi reali del nuovo approccio.
In una pipeline convenzionale, per rendere ricercabile un archivio misto (testi, immagini, audio, video) servono almeno tre passaggi prima che qualsiasi query possa essere processata:
- Trascrizione: l’audio viene convertito in testo tramite un modello STT come Whisper; il video viene elaborato frame per frame da un modello visivo che genera descrizioni testuali
- Conversione immagini: le immagini vengono inviate a un modello di captioning che genera descrizioni testuali
- Embedding: il testo risultante (quello originale + le trascrizioni + le descrizioni generate) viene embeddato con un modello testuale
Ogni passaggio ha un costo: tempo di elaborazione, costo computazionale, e — soprattutto — perdita di informazione. Un audio transcribed perde tutto ciò che non è linguaggio articolato: il tono della voce, le pause, i suoni di sfondo rilevanti. Un’immagine medica captioned da un modello generale perde i dettagli clinici che solo uno specialista saprebbe riconoscere e verbalizzare. Un video di sopralluogo ridotto a una sequenza di descrizioni testuali perde la continuità temporale e i dettagli visivi non verbalizzati.
I risultati produzione dei primi adottori di Gemini Embedding 2 quantificano questi effetti. Sparkonomy, una piattaforma dell’economia creativa, ha sostituito una pipeline a tre modelli con Gemini Embedding 2 e ha misurato una riduzione della latenza del 70% — non per hardware più veloce, ma per la rimozione dei passaggi di elaborazione intermedi. Everlaw, una piattaforma di legal technology specializzata nella discovery in ambito contenziosa, ha misurato un miglioramento del 20% nel recall sulla ricerca su corpus legali eterogenei — ossia su venti casi rilevanti in più ogni cento, su archivi che possono contenere milioni di documenti. In ambito legale, dove un documento non recuperato può essere determinante per l’esito di un procedimento, il miglioramento del recall non è una metrica tecnica astratta.
Le professioni ordinistiche come caso d’uso strutturale
Le professioni intellettuali regolamentate condividono caratteristiche che le rendono candidati naturali per le tecnologie di embedding multimodale. Non perché siano early adopter tecnologici — spesso accade il contrario — ma per la struttura del loro materiale di lavoro.
La natura eterogenea degli archivi professionali è già stata descritta. C’è però una seconda caratteristica: la densità semantica del materiale. I documenti professionali non sono testi di intrattenimento o marketing. Sono atti giuridici, referti clinici, relazioni tecniche in cui ogni parola ha peso specifico, in cui le relazioni tra sezioni diverse del documento sono cariche di significato, in cui il contesto non testuale — una planimetria, un’immagine diagnostica, una fotografia di un cantiere — non è ornamentale ma costitutivo del contenuto informativo.
Questa densità semantica è esattamente ciò per cui i modelli di embedding di alta qualità sono stati concepiti, e per cui la qualità dell’embedding ha un impatto misurabile sulla qualità dei sistemi costruiti sopra. È anche la ragione per cui i benchmark generalistici — come MTEB — vanno integrati con valutazioni su corpus di dominio specifico: un modello che performa eccellentemente su Wikipedia può comportarsi diversamente su fascicoli notarili o referti oncologici.
La terza caratteristica rilevante è la responsabilità giuridica associata all’attività professionale. In nessun ambito come nelle professioni ordinistiche la differenza tra trovare e non trovare un documento rilevante — tra recall alto e recall mediocre — ha conseguenze dirette sulla qualità del servizio reso e, in casi estremi, sulla responsabilità del professionista. Un avvocato che non recupera un precedente rilevante, un medico che non associa un caso clinico corrente a un caso analogo in letteratura, un ingegnere che non rintraccia una relazione tecnica pertinente in un archivio storico: questi non sono fallimenti tecnici astratti, sono fallimenti professionali con conseguenze concrete.
Esaminiamo ora in dettaglio le applicazioni specifiche per ambito, con l’attenzione che ciascuno merita.
Ambito legale e giustizia: quando ogni documento non trovato ha un costo
La discovery come caso emblematico
La legal discovery — il processo di raccolta, revisione e produzione di materiale documentale rilevante in un procedimento giudiziario o in un’indagine — è probabilmente il contesto più paradigmatico per l’embedding multimodale nel settore legale. È un’attività che combina tre caratteristiche che la rendono ideale per testare i limiti dei sistemi AI:
- Volume: nei procedimenti complessi, il corpus da esaminare può contenere milioni di documenti
- Eterogeneità: i documenti includono email, presentazioni, contratti, fotografie, registrazioni audio e video, messaggi istantanei, post su social media archiviati, estratti conto
- Consequenzialità: un documento rilevante non trovato può compromettere una difesa o una causa, con implicazioni legali e finanziarie severe
I sistemi di discovery tradizionali basati su parole chiave soffrono del problema della sinonimia e della polisemia: una ricerca di “pagamento” non troverà documenti che parlano di “bonifico” o “rimessa”; una ricerca di “liquidazione” può recuperare sia documenti sull’estinzione di una società che documenti sulla liquidazione di un danno, mescolandoli. La ricerca semantica basata su embedding risolve strutturalmente questo problema.
Ma il vantaggio dell’embedding multimodale va oltre la ricerca cross-linguistica e cross-terminologica sul testo. In molti procedimenti legali, i “documenti” cruciali non sono testi: sono fotografie (di una scena, di un prodotto difettoso, di un cantiere in un momento specifico), registrazioni audio di conversazioni, video di sopralluogo, file di dati strumentali. Questi elementi, in un sistema text-only, erano o non indicizzati o ridotti a descrizioni testuali imperfette. Con un sistema basato su embedding multimodale nativo, possono essere indicizzati direttamente e recuperati con query testuali che cercano il loro contenuto semantico reale.
Everlaw — la piattaforma di legal tech citata da Google come early access partner — ha misurato un miglioramento del 20% nel recall sulla discovery eterogenea. Su un corpus di un milione di documenti, dove una revisione manuale completa è semplicemente impraticabile, un miglioramento del recall del 20% non è un numero su una presentazione di vendita: è la differenza tra trovare venti documenti rilevanti in più ogni cento, con tutto ciò che questo implica per la completezza dell’analisi.
Ricerca giurisprudenziale e dottrinale
La ricerca di precedenti giurisprudenziali è un’attività fondamentale per avvocati, giudici e qualsiasi professionista del diritto. I sistemi tradizionali — Westlaw, LexisNexis, BancaDati del CNF — sono basati principalmente su indici testuali e classificazioni editoriali. Sono strumenti potenti, ma funzionano bene quando si sa già cosa si cerca: quando si digita la norma giusta, il termine di diritto preciso, il numero di sentenza.
La ricerca semantica cambia il paradigma: permette di cercare “sentenze che abbiano affrontato la responsabilità del venditore in caso di vizi occulti su immobile di pregio” e ottenere risultati rilevanti indipendentemente dai termini tecnici esatti usati nella massimazione o nel testo della sentenza. Con un corpus che include non solo il testo delle sentenze ma anche i documenti allegati — fotografie, planimetrie, perizie con grafici — la ricerca multimodale consente di recuperare precedenti per similarità di situazione fattuale, non solo per identità di qualificazione giuridica.
Per le professioni legali non contenziose — notariato, consulenza stragiudiziale, compliance — la ricerca di precedenti operativi (contratti con clausole analoghe, operazioni societarie simili, schema di atti per fattispecie rare) è un’attività ricorrente che beneficia direttamente dei sistemi RAG costruiti su corpus documentali interni ben indicizzati.
Compliance e antiriciclaggio
Le obbligazioni di due diligence della clientela in ambito antiriciclaggio (D.Lgs. 231/2007 per l’ordinamento italiano, AMLD5 e AMLD6 per il framework europeo) impongono ai professionisti — notai, avvocati, commercialisti, revisori — la raccolta e l’analisi di documentazione eterogenea: documenti di identità in formato immagine, visure camerali in PDF, estratti conto bancari in vario formato, documenti societari stranieri con traduzioni giurate, strutture di proprietà in forma grafica.
Un sistema di indicizzazione multimodale consente di costruire archivi di clientela interrogabili in modo integrato: la query “strutture di controllo con intermediari in giurisdizioni opache identificate in pratiche simili” può recuperare simultaneamente fascicoli di clienti diversi, confrontando pattern documentali eterogenei che difficilmente emergerebbero da una ricerca testuale su un singolo campo.
Ambito medico e sanitario: l’IA come strumento di sintesi clinica
Il problema strutturale dell’informazione clinica
In medicina, la diagnosi è intrinsecamente multimodale. Un medico che valuta un paziente complesso non legge solo la cartella clinica in forma narrativa: osserva immagini diagnostiche, interpreta tracciati strumentali (ECG, spirometria, EEG), valuta fotografie di lesioni dermatologiche, ascolta registrazioni di rumori respiratori, confronta dati di laboratorio in forma tabellare con valori di riferimento e con misurazioni precedenti. La comprensione clinica nasce dall’integrazione di questi flussi informativi eterogenei, non dalla loro somma.
Un articolo del Journal of Medical Internet Research del 2024 sintetizzava il problema con precisione: la diagnosi e la cura di un paziente spesso richiedono che il professionista sanitario ascolti il paziente, esamini la cartella clinica, valuti le immagini mediche e analizzi i risultati degli esami di laboratorio. Questo processo multidimensionale supera le capacità degli attuali sistemi basati solo su LLM testuali. I dati non testuali svolgono un ruolo cruciale nella diagnosi, nella pianificazione del trattamento, nella ricerca e nell’assistenza al paziente.
Gemini Embedding 2 non è un sistema diagnostico — e non ambisce a esserlo. È uno strato infrastrutturale che consente di costruire sistemi di gestione della conoscenza clinica che trattano l’informazione nella sua forma nativa, senza la perdita di contenuto che la conversione in testo introduce.
Archivi di casi clinici indicizzati per similarità
Un’applicazione concreta è la costruzione di archivi di casi clinici interrogabili per similarità multimodale. La query può essere composta: “casi con pattern radiologico simile a questo esame e profilo biochimico nel range X-Y in pazienti con comorbilità cardiovascolare” — e il sistema può recuperare casi pertinenti dall’archivio istituzionale incrociando immagini diagnostiche, referti di laboratorio in forma tabulare, e documentazione clinica narrativa.
Questo tipo di ricerca non è oggi praticabile in modo sistematico nella maggior parte delle strutture sanitarie, non perché manchi la conoscenza clinica per costruire il caso, ma perché mancano le infrastrutture per indicizzare e interrogare corpus eterogenei a questa scala. Le grandi strutture universitarie e i centri di ricerca dispongono di database di casi ben strutturati, ma questi sistemi sono costruiti intorno a classificazioni predeterminate e tag clinici espliciti — non permettono la ricerca semantica per analogia su contenuto non strutturato.
Secondo parere e peer review
La ricerca semantica multimodale su archivi clinici ha implicazioni dirette nella medicina di secondo parere — una pratica clinicamente rilevante che consiste nel sottoporre un caso complesso o dubbio alla valutazione di un secondo specialista. Attualmente, la preparazione di un dossier per il secondo parere richiede una selezione e organizzazione manuale di documentazione eterogenea — un processo che può richiedere ore e che è soggetto a omissioni involontarie.
Un sistema RAG multimodale consente di automatizzare parzialmente questa preparazione: data l’identità del paziente, il sistema recupera dall’archivio tutti i documenti correlati — in tutti i formati in cui sono archiviati — li organizza per rilevanza rispetto alla questione clinica specificata, e li presenta al clinico in modo integrato. La qualità dell’assistenza clinica non dipende dal modello generativo che produce il testo del parere: dipende dalla completezza del contesto informativo recuperato.
Medicina legale e valutazione peritale
La medicina legale è un’area in cui la valutazione di casi richiede l’analisi di corpus documentali particolarmente eterogenei: documentazione sanitaria in vario formato, fotografie di lesioni, video di accertamenti strumentali, registrazioni audio di dichiarazioni, referti di strutture diverse con terminologie non omogenee. La costruzione di un parere peritale richiede l’integrazione di tutte queste fonti, e la capacità di recuperare casi analoghi dalla letteratura e dall’archivio peritale del professionista.
Un sistema di indicizzazione multimodale ben costruito su questo tipo di corpus consente al medico legale di effettuare ricerche per similarità di quadro complessivo — non solo per diagnosi o per meccanismo di lesione, ma per la combinazione di elementi fisici, documentali e circostanziali che caratterizza il caso.
Ingegneria, architettura e professioni tecniche: dove il visivo è costitutivo
Il problema degli archivi tecnici non strutturati
Le professioni tecniche producono e consumano documentazione in cui il contenuto visivo non è accessorio al testo: è parte costitutiva dell’informazione. Una relazione strutturale senza le tavole grafiche è incompleta; una perizia di estimo immobiliare senza le fotografie di stato dei luoghi perde gran parte del suo valore probatorio; un collaudo di un impianto senza i report strumentali in forma grafica è inutilizzabile per fini tecnici.
In un tipico studio di ingegneria o architettura di dimensioni medie, l’archivio storico dei progetti — che può contenere decine o centinaia di commesse accumulate nel corso degli anni — è organizzato per criterio amministrativo o cronologico, non per contenuto semantico. Trovare un precedente tecnico rilevante — un dettaglio costruttivo simile, un caso di dissesto analogo, una soluzione adottata in condizioni strutturali comparabili — richiede conoscenza diretta dell’archivio o una ricerca manuale che può richiedere giorni.
Un sistema RAG multimodale costruito su questo tipo di corpus consente di effettuare ricerche per similarità semantica del contenuto complessivo: testo delle relazioni, schemi grafici, fotografie di cantiere, risultati di prove strumentali. La query “soluzioni di consolidamento adottate in edifici storici con fondazioni su terreno argilloso e muratura in pietrame irregolare” può recuperare fascicoli rilevanti dall’archivio interno, indipendentemente da come siano stati nominati o classificati.
Ispezione e collaudo: il valore dell’audio e del video nativi
Le attività di ispezione tecnica — collaudi strutturali, ispezioni di impianti, rilievi per conformità edilizia o sicurezza sul lavoro — producono sempre più spesso documentazione video e audio. I tecnici usano videocamere (incluse quelle di smartphone o di droni) per registrare lo stato dei manufatti, e spesso registrano annotazioni vocali durante il sopralluogo che integrano le fotografie scattate.
Con i sistemi di embedding precedenti, questo materiale era essenzialmente non indicizzabile in modo integrato: o veniva trascritto (perdendo le informazioni visive) o veniva archiviato in cartelle separate senza possibilità di ricerca semantica. Con un sistema nativo multimodale, video e audio possono essere indicizzati direttamente e recuperati con query testuali che descrivono la situazione tecnica cercata.
L’eliminazione del passaggio di trascrizione è particolarmente significativa per il contenuto audio non verbale: i suoni di un impianto in funzione, i rumori di dissesto strutturale, le frequenze di vibrazione di un componente meccanico — informazioni che semplicemente scompaiono in una trascrizione testuale e che invece un embedding audio nativo può rappresentare e confrontare.
BIM e gestione informativa digitale: verso il fascicolo dell’opera integrato
Dal 1° gennaio 2025, per gli appalti pubblici di importo superiore alle soglie rilevanti, è obbligatorio in Italia l’utilizzo del BIM (Building Information Modelling) e degli strumenti di gestione informativa digitale previsti dal D.M. 312/2021 e dall’allegato I.9 del Codice dei Contratti. Il BIM produce modelli 3D ricchi di dati strutturati, ma anche una quantità crescente di documentazione associata in formati diversi: immagini di progetto, video di cantiere, relazioni tecniche, certificazioni di prodotto in PDF.
L’embedding multimodale consente di costruire sistemi di interrogazione del fascicolo BIM che vadano oltre la navigazione strutturata del modello parametrico: la query “elementi strutturali in acciaio con spessore inferiore a 10mm nelle zone di interfaccia con i solai in carpenteria pesante” può recuperare simultaneamente gli elementi nel modello (se codificati) e i documenti tecnici correlati — specifiche, certificati, fotografie di posa — archiviati in formati non strutturati.
Ambito contabile, fiscale e di revisione
L’eterogeneità degli archivi di studio
Gli studi di commercialisti e revisori gestiscono archivi che combinano bilanci in formato PDF o XBRL, visure camerali, contratti di vario tipo, corrispondenza fiscale, pratiche di contenzioso tributario con allegati diversificati, rendiconti in forma tabellare, verbali di assemblea, delibere in forma mista testo-grafico.
Per i professionisti che svolgono attività di pianificazione fiscale o di strutturazione di operazioni straordinarie, la ricerca di precedenti — operazioni societarie analoghe, trattamenti fiscali adottati in fattispecie simili, orientamenti di prassi su questioni interpretative — è un’attività che beneficia direttamente dei sistemi RAG costruiti su corpus documentali ben indicizzati. La capacità di interrogare un archivio che include non solo i testi dei pareri e delle risoluzioni di prassi, ma anche i documenti aziendali allegati — bilanci, strutture societarie in forma grafica, planimetrie di immobili oggetto di operazioni — aggiunge un livello di contestualizzazione che i sistemi text-only non possono offrire.
Revisione legale dei conti e audit
In ambito di revisione, la verifica di un campione di transazioni richiede l’esame di documentazione eterogenea: fatture in PDF (che spesso contengono loghi, timbri, elementi grafici non testuali), ordini di acquisto, DDT, estratti conto, contratti quadro. La capacità di indicizzare questi documenti in modo multimodale — cogliendo non solo il testo estratto ma anche il layout, gli elementi grafici e le relazioni visive tra componenti del documento — migliora la qualità della ricerca e consente di identificare pattern anomali (fatture con layout inconsueto, timbri non conformi agli standard) che una ricerca puramente testuale non rileverebbe.
Questioni tecniche che chi costruisce questi sistemi deve considerare
Il problema del chunking su corpus eterogeneo
La finestra di input per richiesta di Gemini Embedding 2 è definita: 8.192 token per il testo, 6 immagini, 120 secondi di video, 80 secondi di audio, 6 pagine di PDF. Per archivi reali — documenti di centinaia di pagine, video di ore, corpus di migliaia di file — questo implica una strategia di segmentazione (chunking) del corpus prima dell’indicizzazione.
Il chunking non è un problema banale, e la sua qualità ha un impatto diretto sulla qualità del recupero. Per il testo, le strategie ottimali dipendono dalla struttura del documento: un chunk che taglia nel mezzo di un paragrafo perde il contesto; un chunk troppo grande non consente al modello di focalizzarsi sulla parte rilevante. Per le immagini, la suddivisione di una planimetria o di un grafico tecnico richiede attenzione alla coerenza semantica delle sezioni. Per i video, la scelta dei punti di taglio influenza la capacità del sistema di recuperare momenti specifici.
La strategia di chunking ottimale per un corpus professionale — che combina documenti con struttura molto diversa — richiede soluzioni adattive al tipo di contenuto, non un’unica lunghezza fissa applicata a tutto. Questo è un aspetto che i sistemi standard “fuori dalla scatola” gestiscono in modo mediocre, e che richiede un investimento progettuale specifico.
Incompatibilità degli spazi vettoriali tra modelli diversi
I vettori prodotti da Gemini Embedding 2 sono incompatibili con quelli prodotti da qualsiasi altro modello di embedding — incluso gemini-embedding-001 di Google. I due modelli producono rappresentazioni in spazi vettoriali con coordinate fondamentalmente diverse: confrontare un vettore prodotto da un modello con un vettore prodotto dall’altro usando metriche di similarità produce risultati privi di significato.
Questo ha una conseguenza pratica immediata per chiunque stia valutando una migrazione da un sistema esistente: l’intera base documentale deve essere re-indicizzata. Non è possibile migrare gradualmente, mantenendo parte del corpus indicizzato con il vecchio modello e parte con il nuovo. È un’operazione di conversione completa, con i costi computazionali e i tempi che questo comporta.
Per corpus di grandi dimensioni, la strategia raccomandata è il shadow indexing: mantenere in produzione il sistema esistente, costruire in parallelo il nuovo indice su un sistema separato, testarlo su un dataset di valutazione rappresentativo del dominio, calibrare le soglie di similarità (che cambiano tra modelli), e poi effettuare il cutover. Il costo di questa transizione non deve essere sottostimato nella valutazione di adozione.
Calibrazione delle soglie di similarità
Ogni modello di embedding distribuisce i vettori diversamente nello spazio latente. I valori di similarità coseno che fungono da soglia di rilevanza in un sistema RAG — tipicamente nell’intervallo 0,6-0,8 — vanno ricalibrati dopo ogni cambio di modello. Il valore che funzionava come soglia di rilevanza con il modello precedente può produrre troppi o troppo pochi risultati con il nuovo.
La calibrazione richiede un dataset di valutazione rappresentativo del dominio specifico: coppie query-risposta giudicate rilevanti da esperti del settore, su cui misurare precision e recall al variare della soglia. Per un corpus professionale specializzato — fascicoli legali, cartelle cliniche, archivi tecnici — questo dataset non può essere importato da benchmark generici: va costruito specificamente per il contesto di utilizzo.
Dati personali, segreto professionale e conformità GDPR
Le professioni ordinistiche operano su dati che per definizione sono soggetti a obblighi di riservatezza particolarmente stringenti: segreto professionale degli avvocati, riservatezza delle cartelle cliniche, riservatezza degli atti notarili, obbligo di riservatezza dei commercialisti e dei revisori. Molti di questi dati sono anche dati personali ai sensi del GDPR, e spesso dati appartenenti alle categorie particolari (dati sulla salute, dati giudiziari, dati di orientamento politico).
L’utilizzo di un’API cloud — anche di un fornitore di primo livello con adeguate garanzie contrattuali — per l’indicizzazione di questo tipo di materiale richiede una valutazione di conformità attenta, che include:
- Verifica del Data Processing Agreement: i termini contrattuali di Google Cloud prevedono un DPA conforme al GDPR; è necessario verificare che sia attivato e che le condizioni di trasferimento dei dati siano compatibili con le normative applicabili al settore professionale specifico
- Valutazione del trasferimento extraeuropeo: Google Cloud offre regioni europee (tra cui Milano/Zurigo) per il deployment su Vertex AI; è necessario verificare che il flusso dei dati sia configurato per rimanere nell’UE se questo è un requisito di conformità
- Impatto sulla valutazione DPIA: per trattamenti ad alto rischio (come quelli su dati sanitari o giudiziari), il GDPR richiede una valutazione d’impatto sulla protezione dei dati (DPIA) che deve tenere conto dei nuovi strumenti tecnologici adottati
- Segreto professionale: per avvocati e notai, l’obbligo di segreto professionale ha fondamento anche deontologico oltre che normativo; l’invio di contenuti di atti o fascicoli a sistemi cloud deve essere valutato in relazione agli obblighi deontologici applicabili
Per i professionisti con esigenze di riservatezza particolarmente stringenti, esiste l’alternativa del deployment on-premise o in cloud privato: Vertex AI offre opzioni di deployment enterprise con garanzie di isolamento dei dati più stringenti, a costi e complessità maggiori.
Il quadro regolatorio europeo come fattore di sistema
L’AI Act europeo — Regolamento (UE) 2024/1689, entrato in applicazione graduata nel corso del 2025 e 2026 — classifica i sistemi AI in funzione del rischio che presentano e impone obblighi proporzionali. Per i sistemi AI destinati a influenzare decisioni in ambiti ad alto impatto — tra cui istruzione, occupazione, accesso a servizi essenziali, amministrazione della giustizia, assistenza medica — le classificazioni di rischio più elevate implicano obblighi di trasparenza, tracciabilità, supervisione umana e valutazione della conformità.
Un sistema RAG multimodale costruito su corpus professionali che contribuisce a orientare decisioni diagnostiche, valutazioni peritali o pareri legali rientra potenzialmente nelle categorie ad alto rischio dell’AI Act. Questo non pregiudica l’adozione — l’AI Act non vieta questi sistemi — ma impone che siano progettati con caratteristiche specifiche:
- Tracciabilità del ragionamento: il sistema deve permettere di identificare quali documenti e quali passaggi hanno alimentato una risposta o una raccomandazione
- Supervisione umana: le decisioni finali devono restare prerogativa del professionista umano, con il sistema che fornisce supporto e non sostituisce il giudizio
- Comunicazione agli utenti: in molti contesti, chi usa un sistema che si avvale di AI deve essere informato del fatto che sta interagendo con un sistema AI
- Documentazione del sistema: il fornitore e/o l’utilizzatore del sistema deve mantenere documentazione tecnica adeguata sul modello usato, sui dati su cui è stato addestrato o affinato, e sulle misure di mitigazione del rischio adottate
La norma tecnica UNI EN ISO/IEC 42001:2024 — relativa ai sistemi di gestione dell’intelligenza artificiale nelle organizzazioni — offre un framework di riferimento per strutturare la governance AI in modo auditabile, compatibile con le richieste dell’AI Act.
L’Italia ha adottato la Legge 132/2025, che per la prima volta affronta in modo organico l’impatto delle tecnologie AI sulle professioni intellettuali, stabilendo principi chiari per l’utilizzo responsabile di questi strumenti nelle attività professionali regolamentate. Il principio fondamentale è che l’AI può essere utilizzata come strumento di supporto, ma la prevalenza del giudizio professionale umano resta indiscussa e la responsabilità per i contenuti prodotti con l’ausilio dell’AI rimane in capo al professionista.
Limiti attuali che non devono essere sottovalutati
Deriva di dominio
I modelli di embedding — incluso Gemini Embedding 2 — sono addestrati su dati generici. La loro qualità su corpus altamente specializzati può essere inferiore a quanto i benchmark generici suggerirebbero. Su testi legali italiani con terminologia tecnica specifica, su refertistica clinica con abbreviazioni e convenzioni di dominio, su documentazione tecnica in linguaggi specialistici, la distanza semantica tra termini tecnici e i loro sinonimi o varianti potrebbe non essere catturata con la stessa accuratezza con cui viene catturata su testi generici.
La soluzione è il fine-tuning — addestrare il modello su dati di dominio specifici per migliorarne la capacità di rappresentazione semantica nel contesto professionale — ma questa è un’operazione che richiede dati di addestramento di qualità, expertise tecnica, e investimento. Google documenta che Gemini Embedding 2 mostra “robustezza al domain shift” superiore ai predecessori, ma questo non elimina il problema su domini particolarmente specializzati.
Il “black box” della similarità semantica
I sistemi di embedding non sono interpretabili nel senso tradizionale: non è possibile spiegare perché il modello considera due documenti semanticamente vicini o lontani. Questo crea una difficoltà in contesti professionali in cui la tracciabilità del ragionamento è un requisito — non solo per il GDPR e l’AI Act, ma per la deontologia professionale stessa.
Un sistema RAG che recupera un documento e lo usa come contesto per generare una risposta deve essere in grado di mostrare all’utente quale documento è stato recuperato e perché — non il perché nel senso dell’algoritmo interno (che non è accessibile), ma almeno la citazione della fonte. Questo è un problema di design del sistema, non del modello in sé: la soluzione è progettare la pipeline in modo che ogni risposta riporti le fonti che l’hanno alimentata, e che il professionista possa verificarle.
Costi di produzione su corpus di grandi dimensioni
A $0,25 per milione di token per testo, il costo di indicizzazione di un corpus documentale di grandi dimensioni è calcolabile. Un archivio di 500.000 pagine di testo, con una media di 500 token per pagina, corrisponde a 250 milioni di token — un costo di indicizzazione iniziale di circa $62,50. La Batch API dimezza questo costo. Il costo diventa rilevante per corpus molto grandi, per le modalità audio (tariffate a $0,50 per milione di token) e per i cicli di re-indicizzazione che accompagnano le migrazioni di sistema.
Il costo operativo corrente — le query di ricerca che avvengono continuamente in produzione — è proporzionale al volume di utilizzo, ma tipicamente è inferiore al costo di indicizzazione per corpus stabili. Il calcolo del TCO (Total Cost of Ownership) di un sistema RAG multimodale deve considerare: costo di indicizzazione iniziale, costo di re-indicizzazione degli aggiornamenti, costo delle query, costo di storage del database vettoriale, costo dell’infrastruttura di serving, e — spesso sottostimato — il costo del lavoro tecnico per costruire e mantenere la pipeline.
Prospettiva di sistema: embedding e agenti AI
C’è un’ultima dimensione che merita attenzione per chi guarda oltre l’utilizzo immediato degli strumenti disponibili oggi.
L’intelligenza artificiale si sta evolvendo verso sistemi di agenti autonomi — sistemi che non solo recuperano e sintetizzano informazioni, ma che eseguono sequenze di azioni per completare obiettivi complessi: condurre ricerche multi-step, preparare bozze di documenti, aggregare informazioni da fonti diverse, monitorare corpora per rilevare aggiornamenti rilevanti.
Perché un agente AI operi efficacemente in un dominio professionale, ha bisogno di una memoria affidabile — un sistema che rappresenti il contesto del suo dominio operativo in modo da poterlo interrogare dinamicamente. L’embedding multimodale è la tecnologia che rende questa memoria possibile: non una memoria testuale, ma una rappresentazione della conoscenza professionale nella sua forma nativa eterogenea.
Un agente che assiste un professionista legale nella preparazione di un’udienza non può operare su una base di conoscenza che include solo i testi degli atti: ha bisogno di accedere alle fotografie degli exhibit, alle trascrizioni delle deposizioni, ai video dei sopralluogo, ai documenti contabili in forma tabellare. Un embedding space unificato è la condizione necessaria perché questo sia possibile.
Gemini Embedding 2 va quindi letto non solo come uno strumento di ricerca semantica più sofisticata, ma come un’infrastruttura che abilita la prossima generazione di assistenti AI professionali — sistemi che non interagiscono con frammenti testuali della realtà professionale, ma con la sua complessità nella forma in cui essa esiste.
Considerazioni finali
Gemini Embedding 2 è un componente infrastrutturale — la distinzione è importante. Non è un prodotto verticale per avvocati, medici o ingegneri; non offre soluzioni preconfezionate per alcuna professione. Offre un livello tecnologico — quello della rappresentazione semantica unificata di informazione multimodale — su cui costruire sistemi con caratteristiche strutturalmente nuove.
Il suo valore non sta nella capacità generativa, nella brillantezza delle risposte, nell’eleganza dell’interfaccia. Sta nella qualità con cui risolve un problema tecnico preciso: rendere comparabili e ricercabili, in un unico spazio semantico, informazioni che fino a oggi vivevano in compartimenti separati — testo, immagine, audio, video, documento — richiedendo infrastrutture distinte, pipeline laboriose, e accettando inevitabili perdite di informazione nelle conversioni intermedie.
Per le professioni che lavorano su archivi documentali eterogenei — e le professioni ordinistiche sono per definizione in questa categoria — il passaggio da sistemi di retrieval text-only a sistemi di retrieval multimodale nativo rappresenta il cambiamento infrastrutturale più significativo degli ultimi anni nell’ambito dell’AI applicata. Non perché i modelli generativi che stanno sopra siano migliorati — quelli continuano a evolvere indipendentemente — ma perché la qualità del recupero informativo determina la qualità del contesto su cui quei modelli operano.
Garbage in, garbage out — vale anche per i sistemi AI più sofisticati. Se il recupero è incompleto, il contesto è parziale, la risposta è degradata. La qualità dell’embedding è la qualità del recupero. E la qualità del recupero è la qualità del sistema.
Questo non modifica la natura del giudizio professionale, che rimane prerogativa esclusiva del professionista e presupposto irrinunciabile della sua responsabilità deontologica e civile. Modifica le condizioni in cui quel giudizio si esercita: la completezza dell’informazione recuperabile, la capacità di trovare precedenti e analogie in archivi storici non strutturati, la possibilità di costruire sistemi di supporto alla decisione commisurati alla complessità informativa reale della pratica professionale.
La valutazione di opportunità e rischi — come sempre — è una responsabilità che nessun sistema può delegare.
Articolo pubblicato su Notizie dall’Arena — notaiosoldani.it
#IntelligenzaArtificiale #AIMultimodale #GeminiEmbedding2 #LegalTech #MedTech #ProfessioniOrdinistiche #RAG #VectorSearch #MachineLearning #DigitalTransformation #AIAct #EmbeddingModel #KnowledgeManagement
Il presente articolo ha carattere generale e informativo, non costituisce parere legale personalizzato e non sostituisce la consulenza diretta con un notaio. Per assistenza specifica relativa alla vostra situazione, vi invitiamo a contattare il nostro Studio per fissare un appuntamento. Contenuto generato con sistemi di Intelligenza Artificiale e supervisionato da professionisti dello Studio Notarile, in conformità ai requisiti di trasparenza del Regolamento UE 2024/1689 (AI Act).