
 Da Manlio Carlo Soldani
Indice dei contenuti
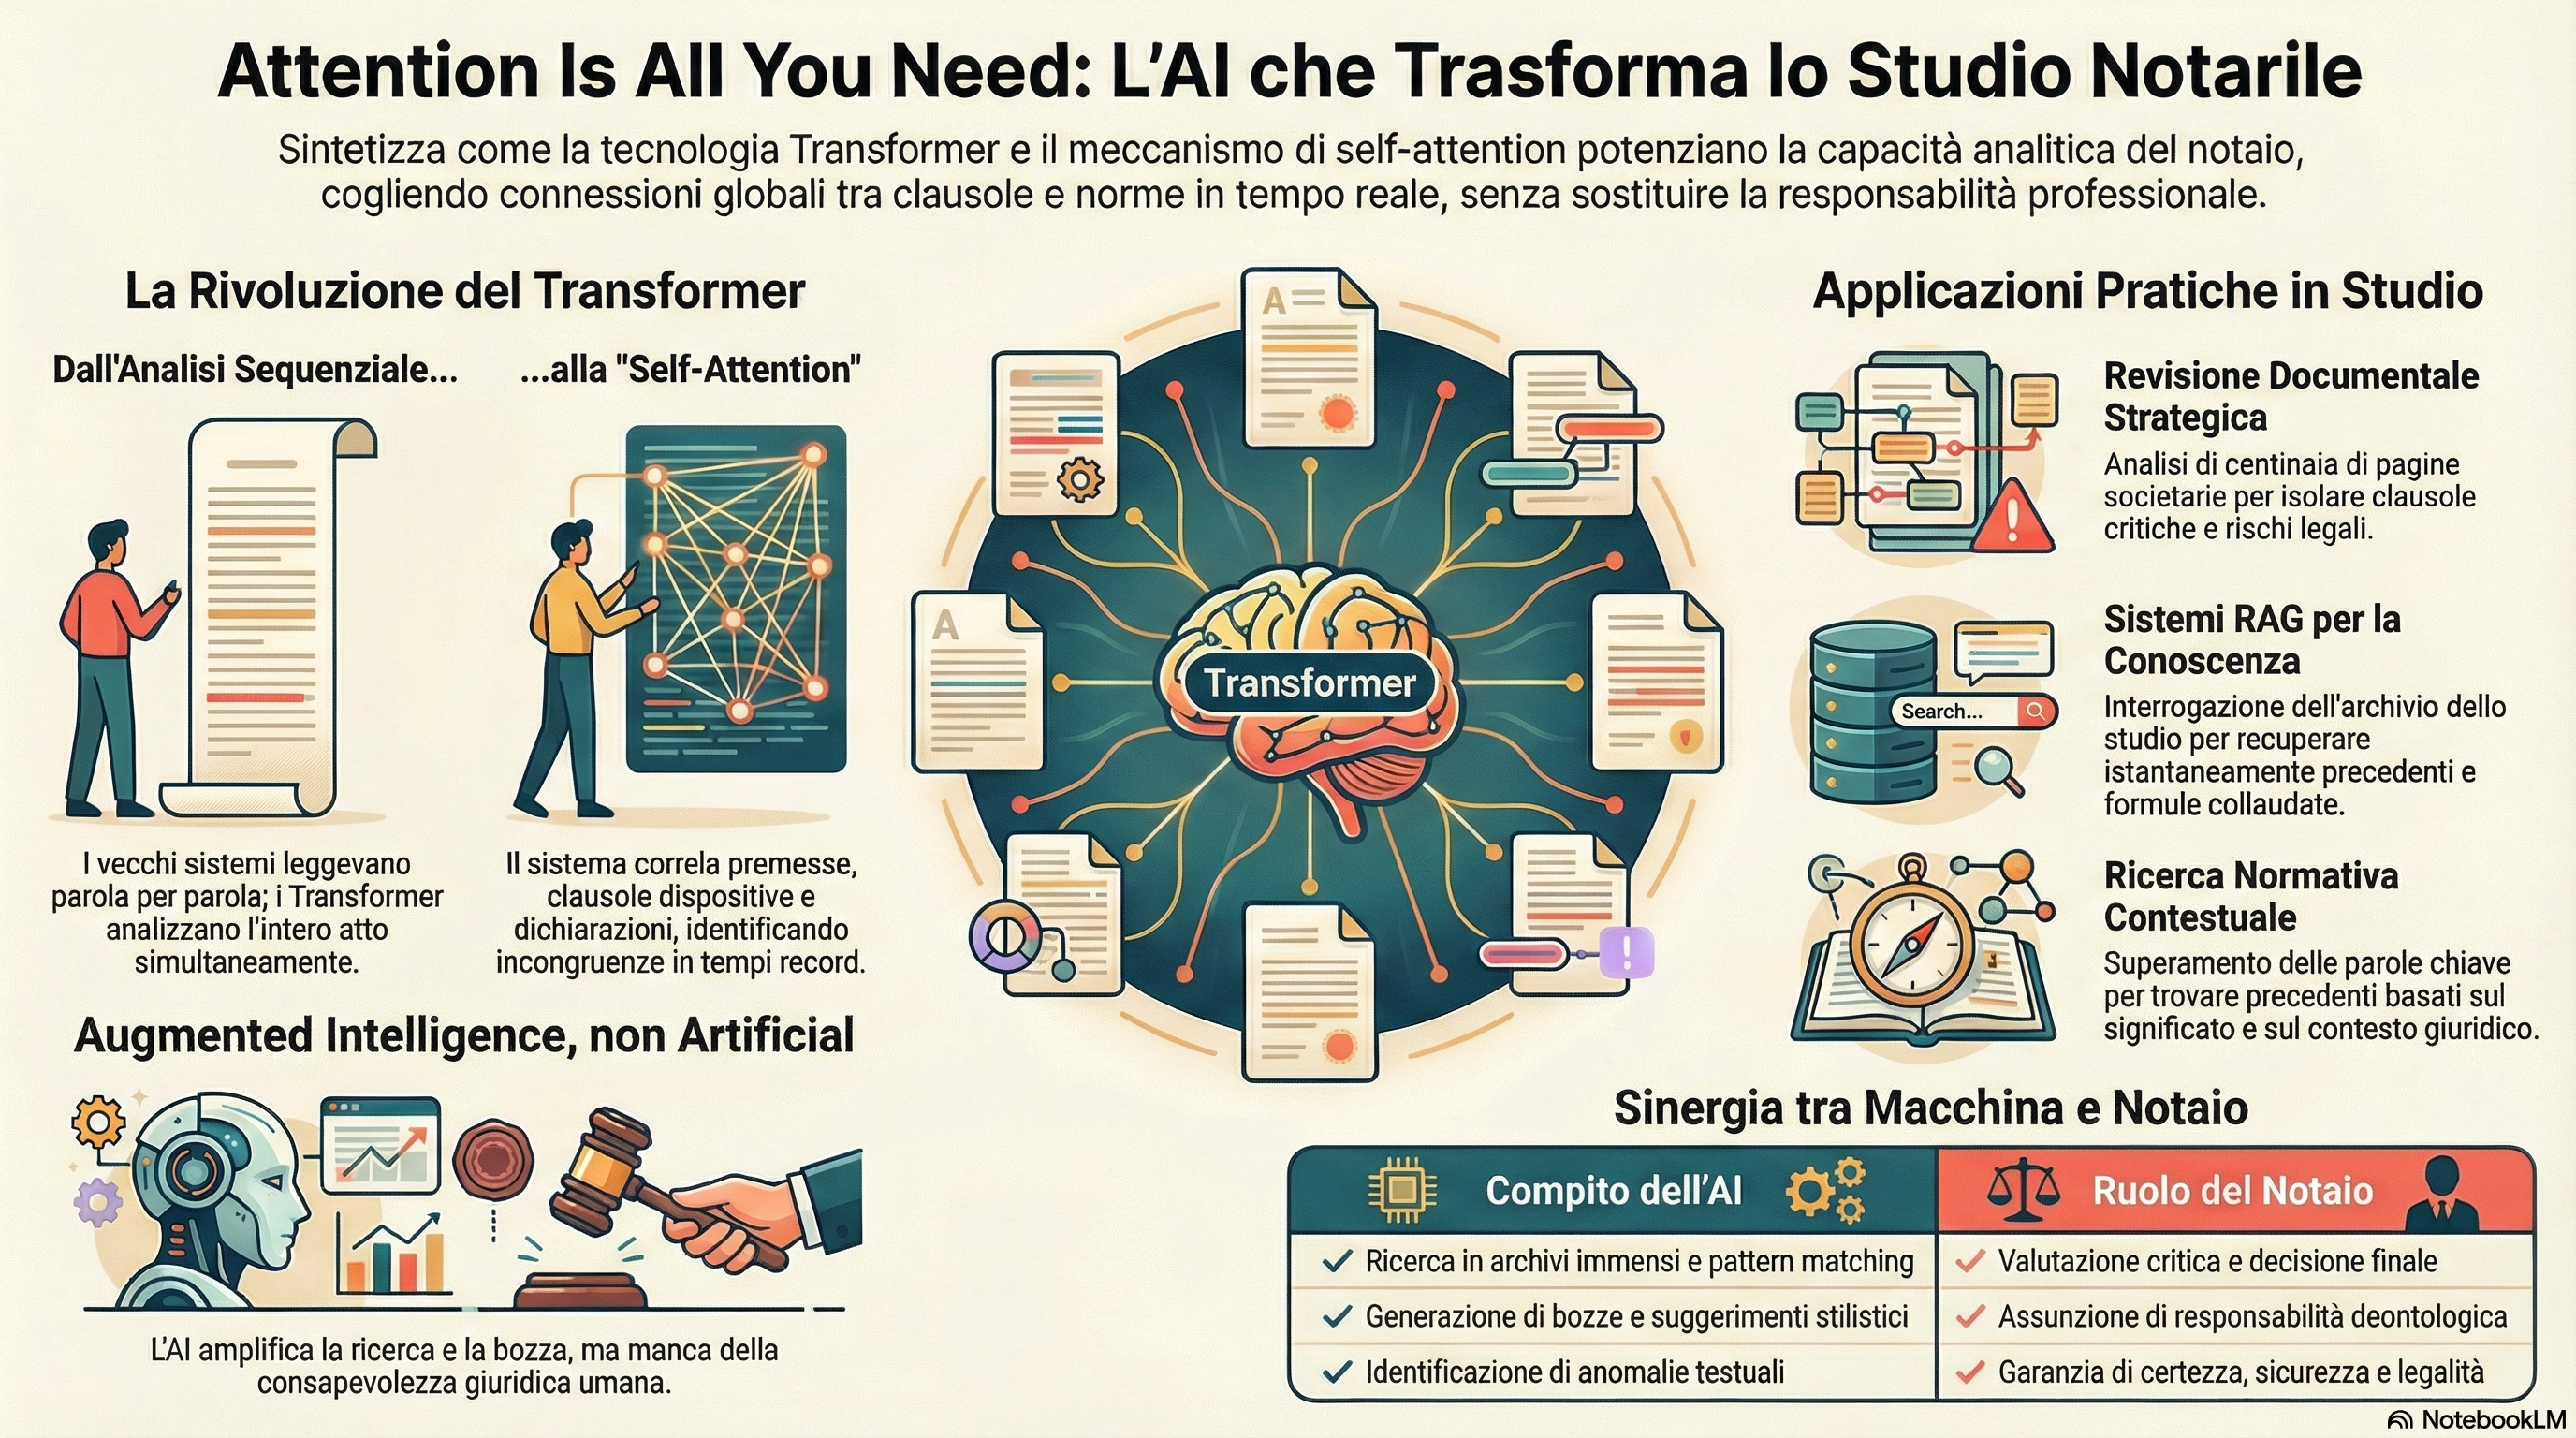
Il paper “Attention Is All You Need”, pubblicato nel giugno 2017 da otto ricercatori di Google Brain e Google Research, ha introdotto l’architettura Transformer che costituisce oggi la base di praticamente tutti i modelli linguistici moderni, da BERT a GPT fino agli LLM più avanzati come Claude, GPT-4 e Gemini. Con oltre 173.000 citazioni al 2025, si colloca tra i dieci paper più citati del XXI secolo e rappresenta probabilmente il singolo contributo più influente nella storia recente dell’intelligenza artificiale.
Le Origini e gli Aneddoti Dietro la Rivoluzione
Il Team e la Genesi dell’Idea
Gli otto autori del paper sono Ashish Vaswani, Noam Shazeer, Niki Parmar, Jakob Uszkoreit, Llion Jones, Aidan Gomez, Łukasz Kaiser e Illia Polosukhin, tutti elencati come “equal contributors” con ordine randomizzato per enfatizzare il carattere collaborativo della scoperta. Il titolo stesso è un omaggio alla celebre canzone dei Beatles “All You Need Is Love”, mentre il nome “Transformer” fu scelto semplicemente perché a Jakob Uszkoreit piaceva il suono di quella parola – una scelta apparentemente casuale che si è poi rivelata profetica dato che questi modelli hanno letteralmente “trasformato” il campo dell’AI.
Un documento di design preliminare era intitolato “Transformers: Iterative Self-Attention and Processing for Various Tasks” e includeva illustrazioni di sei personaggi del franchise cinematografico Transformers, evidenziando l’atmosfera ludica e creativa del team. Tuttavia, dietro questa apparente leggerezza c’era un’intuizione scientifica profonda che andava contro la saggezza convenzionale dell’epoca.
Lo Scetticismo Iniziale
L’aneddoto forse più significativo riguarda proprio Jakob Uszkoreit, che già nel 2016 lavorava su un modello chiamato “decomposable attention” applicando meccanismi di self-attention a reti feedforward. Durante questo lavoro, Uszkoreit ebbe l’intuizione che l’attenzione senza ricorrenza potesse essere sufficiente per compiti complessi come la traduzione linguistica – da cui il titolo provocatorio “attention is all you need”. Questa ipotesi era così radicale che persino suo padre Hans Uszkoreit, noto linguista computazionale di primo piano, era profondamente scettico. L’establishment accademico riteneva infatti che le reti ricorrenti (RNN e LSTM) fossero componenti indispensabili per processare sequenze linguistiche, dato che solo esse potevano mantenere una “memoria” dell’ordine delle parole.
La dimostrazione empirica che l’attenzione da sola era sufficiente – anzi, superiore – rappresentò quindi non solo un’innovazione tecnica ma una vera rottura epistemologica. Dopo la pubblicazione e il successo travolgente del paper, tutti e otto gli autori hanno lasciato Google per unirsi ad altre aziende o fondare startup, disseminando l’architettura Transformer attraverso l’intero ecosistema dell’AI: Ashish Vaswani ha fondato Adept AI, Aidan Gomez ha creato Cohere, Illia Polosukhin ha co-fondato NEAR Protocol, mentre Noam Shazeer è stato tra i fondatori di Character.AI (recentemente riacquistata da Google).
L’Architettura Transformer: Anatomia di una Rivoluzione
Il Problema delle Architetture Precedenti
Prima del Transformer, i modelli dominanti per il processamento del linguaggio naturale erano le reti ricorrenti (RNN) e le loro varianti più sofisticate come LSTM (Long Short-Term Memory) e GRU (Gated Recurrent Units). Questi modelli processavano le sequenze di parole in modo sequenziale, una alla volta, mantenendo uno “stato nascosto” che veniva aggiornato a ogni passo temporale. Questo approccio presentava tre limitazioni fondamentali.
Prima, la dipendenza sequenziale impediva la parallelizzazione del calcolo: per processare la parola n-esima, il modello doveva aver già completato l’elaborazione delle n-1 parole precedenti. Questo rendeva il training estremamente lento, soprattutto su sequenze lunghe. Seconda, il problema del vanishing gradient rendeva difficile per le RNN catturare dipendenze a lungo raggio: informazioni all’inizio di una frase lunga tendevano a “svanire” quando il modello arrivava alla fine. Terza, anche quando le RNN funzionavano, la loro capacità di catturare relazioni complesse tra parole distanti nella sequenza rimaneva limitata.
I meccanismi di attenzione erano già stati introdotti nel 2014-2015 come “add-on” alle RNN per mitigare il problema delle dipendenze a lungo raggio, permettendo al decoder di “guardare indietro” a tutte le posizioni dell’encoder. Ma nessuno aveva ancora osato eliminare completamente la componente ricorrente – fino al 2017.
Self-Attention: Il Cuore dell’Innovazione
Il meccanismo di scaled dot-product attention è il cuore pulsante del Transformer. L’intuizione è elegantemente semplice: ogni parola nella sequenza può “interrogare” (query) tutte le altre parole per determinare quanto dovrebbe “prestare attenzione” a ciascuna di esse. Il prodotto scalare tra query e key calcola una matrice di punteggi di similarità tra ogni coppia di posizioni, la funzione softmax normalizza questi punteggi in una distribuzione di probabilità, e infine questi pesi moltiplicano i value per produrre l’output.
Il fattore di scaling (la radice quadrata della dimensione dei key, inizialmente impostata a 64) si è rivelato cruciale per le prestazioni. Gli autori ipotizzarono che per valori grandi di questa dimensione, il prodotto scalare tende ad avere magnitudini molto grandi, spingendo la funzione softmax in regioni dove i gradienti sono estremamente piccoli. Il scaling contrasta questo effetto mantenendo la varianza dei prodotti scalari stabile indipendentemente dalla dimensione.
La self-attention differisce dai meccanismi di attenzione precedenti (2014) in un aspetto fondamentale: query, key e value provengono tutte dalla stessa fonte – la sequenza di input stessa – permettendo a ogni posizione di relazionarsi con tutte le altre posizioni nella stessa sequenza. Questo elimina completamente la necessità di ricorrenza e garantisce piena parallelizzabilità: tutti i punteggi di attenzione possono essere calcolati simultaneamente, riducendo drasticamente i tempi di training.
Multi-Head Attention: Prospettive Multiple Simultanee
Il meccanismo di multi-head attention potenzia ulteriormente il processo introducendo molteplici “teste” di attenzione parallele. Invece di performare un singolo calcolo di attenzione con dimensioni complete, il modello apprende diverse proiezioni lineari delle matrici query, key e value, ciascuna con dimensioni ridotte.
Nel paper originale, gli autori usarono 8 teste parallele. Questa architettura permette al modello di catturare simultaneamente diversi tipi di relazioni tra le parole: una testa potrebbe concentrarsi su dipendenze sintattiche (soggetto-verbo), un’altra su relazioni semantiche (co-riferimenti), un’altra ancora su pattern posizionali. Dopo il calcolo degli output di tutte le teste, questi vengono concatenati e passati attraverso una trasformazione lineare finale.
Analisi successive hanno rivelato che diverse teste apprendono effettivamente pattern specializzati: alcune si concentrano su token adiacenti (catturando bigrams), altre su dipendenze a lungo raggio, altre ancora sviluppano comportamenti più astratti difficili da interpretare ma cruciali per le prestazioni complessive.
Positional Encoding: Recuperare l’Ordine delle Parole
Poiché il Transformer non si basa su ricorrenza o convoluzione, l’architettura è intrinsecamente permutation-invariant: senza informazioni addizionali, tratta la sequenza “il gatto mangia il topo” esattamente come “il topo mangia il gatto”. Per iniettare informazioni sull’ordine delle parole, il paper introdusse il positional encoding usando funzioni sinusoidali con diverse frequenze.
La scelta delle funzioni sinusoidali non fu casuale. Gli autori ipotizzarono che questo schema potesse permettere al modello di “estrapolare” a lunghezze di sequenza maggiori di quelle viste durante il training, poiché ogni posizione futura sarebbe semplicemente una combinazione lineare delle funzioni base. Inoltre, per qualsiasi offset fisso, l’encoding posizionale a posizione+k può essere rappresentato come funzione lineare dell’encoding a posizione, permettendo al modello di apprendere facilmente a “prestare attenzione” a posizioni relative.
Nei modelli successivi, molti ricercatori hanno sperimentato con learned positional embeddings (embeddings posizionali appresi), trovando prestazioni simili o leggermente superiori, ma la soluzione sinusoidale originale rimane elegante per la sua generalizzabilità teorica a sequenze arbitrariamente lunghe.
L’Architettura Completa: Encoder-Decoder
Il Transformer completo consiste in uno stack di encoder (6 layer nel paper originale) e uno stack di decoder (altri 6 layer). Ogni layer dell’encoder contiene due sub-layer: un multi-head self-attention e una rete feed-forward fully-connected. Ogni layer del decoder contiene tre sub-layer: un masked multi-head self-attention (per prevenire che posizioni future influenzino la predizione corrente), un multi-head attention che attende all’output dell’encoder, e una rete feed-forward.
Crucialmente, ogni sub-layer è avvolto in una residual connection seguita da layer normalization. Le residual connections permettono ai gradienti di fluire direttamente attraverso la rete durante il backpropagation, facilitando il training di architetture profonde. La layer normalization stabilizza il training normalizzando gli input di ogni layer.
La rete feed-forward è identica in ogni posizione ma con parametri indipendenti tra layer, con dimensione interna di 2048 (quattro volte la dimensione del modello di 512). Questa non-linearità si è rivelata essenziale: esperimenti successivi hanno mostrato che rimuovere la FFN degrada significativamente le prestazioni.
I Risultati Sperimentali e l’Efficienza Computazionale
Training e Benchmark
Il modello originale base conteneva 65 milioni di parametri, mentre il modello “big” ne aveva circa 213 milioni – numeri che oggi sembrano minuscoli confrontati con i modelli moderni da centinaia di miliardi di parametri, ma che all’epoca rappresentavano scale significative. Il training fu condotto su 8 GPU NVIDIA P100, con il modello base che richiese solo 12 ore di training e il modello big completato in 3,5 giorni – un’efficienza straordinaria rispetto ai modelli ricorrenti dell’epoca che potevano richiedere settimane.
Sul benchmark standard WMT 2014 English-German (4,5 milioni di coppie di frasi), il modello Transformer raggiunse 28,4 BLEU, superando i migliori risultati esistenti – inclusi ensemble di modelli – di oltre 2 punti BLEU. Ancora più impressionante, sul task English-French (36 milioni di coppie), stabilì un nuovo stato dell’arte con 41,8 BLEU, ottenuto con un costo di training di solo 1/4 rispetto ai migliori modelli precedenti.
Complessità Computazionale e Parallelizzazione
Un’analisi chiave del paper confrontava la complessità computazionale per layer di diverse architetture. Il self-attention ha complessità quadratica rispetto alla lunghezza della sequenza ma solo operazioni sequenziali costanti (completamente parallelizzabile). Le recurrent layer hanno complessità lineare rispetto alla lunghezza ma operazioni sequenziali lineari (inherentemente seriali). Le convolutional layer hanno complessità che dipende dalla dimensione del kernel.
Per sequenze tipiche, il self-attention è computazionalmente più efficiente delle RNN, e soprattutto è completamente parallelizzabile. Questo ha sbloccato l’utilizzo efficiente delle GPU moderne, che eccellono in operazioni matriciali parallele. La “lunghezza del percorso massimo” tra qualsiasi coppia di posizioni nella rete – una proxy per quanto facilmente il modello può apprendere dipendenze a lungo raggio – è costante per il self-attention (ogni posizione può attendere direttamente a ogni altra) contro lineare per le RNN.
Prime Applicazioni Beyond Translation
Già nella primavera del 2017, prima della pubblicazione ufficiale del preprint su arXiv, uno dei co-autori sperimentò con una variante “decoder-only” dell’architettura per generare articoli fittizi di Wikipedia. Fornendo solo un titolo e una prima frase, il modello produceva paragrafi coerenti e stilisticamente appropriati. Questo esperimento precoce prefigurò l’architettura GPT (Generative Pre-trained Transformer) che OpenAI avrebbe rilasciato solo pochi mesi dopo, dimostrando la versatilità del paradigma Transformer ben oltre la traduzione.
Chain-of-Thought: Il Pensiero Esplicito nei LLM
Il Problema del Ragionamento nei Large Language Models
Mentre i Transformer e i loro discendenti come GPT-3 dimostravano capacità impressionanti su task linguistici standard, emergeva un gap significativo nelle loro capacità di ragionamento multi-step. Problemi che richiedevano ragionamento aritmetico, ragionamento di senso comune o pianificazione sequenziale rimanevano sorprendentemente difficili anche per modelli con decine o centinaia di miliardi di parametri.
Un esempio tipico: dato il problema “Roger ha 5 palline da tennis. Compra 2 confezioni da 3 palline ciascuna. Quante palline ha ora?”, modelli molto grandi tendevano a fornire risposte errate o incoerenti quando interrogati direttamente. L’ipotesi prevalente era che, forzati a produrre immediatamente la risposta finale, i modelli non avessero “spazio computazionale” sufficiente per svolgere i passaggi intermedi necessari.
Il Breakthrough di Wei et al. (2022)
Nel gennaio 2022, Jason Wei, Xuezhi Wang, Dale Schuurmans, Maarten Bosma, Brian Ichter, Fei Xia, Ed Chi, Quoc Le e Denny Zhou – un team prevalentemente di Google Research – pubblicarono “Chain-of-Thought Prompting Elicits Reasoning in Large Language Models”, introducendo un metodo disarmantemente semplice ma rivoluzionario: invece di chiedere direttamente la risposta, fornire al modello esempi che mostrano il processo di ragionamento intermedio.
Il metodo consiste nel costruire prompt few-shot dove, oltre all’input e all’output, si includono i “passi di pensiero” che collegano i due. Per il problema delle palline da tennis, un esempio CoT includerebbe: “Roger inizia con 5 palline. 2 confezioni da 3 palline sono 2 × 3 = 6 palline. 5 + 6 = 11. La risposta è 11.”
I risultati furono straordinari. Su un modello PaLM da 540 miliardi di parametri, con soli otto esempi di chain of thought nel prompt, raggiunsero il 57% di accuratezza sul benchmark GSM8K (problemi di matematica a livello di scuola elementare), superando persino GPT-3 175B fine-tuned con un verificatore – che aveva richiesto training supervisionato su 7.500 esempi. Questo rappresentava un salto di 23 punti percentuali rispetto allo standard prompting.
Proprietà Emergenti e Scaling
Una scoperta fondamentale fu che il CoT prompting mostra proprietà emergenti rispetto alla scala del modello. Su modelli sotto i 10 miliardi di parametri, aggiungere chain of thought al prompt aveva impatto minimo o nullo – talvolta peggiorando persino le prestazioni. Ma oltre una soglia critica (circa 50-100B parametri), il beneficio diventava drammatico e cresceva con la scala. Questo suggerisce che la capacità di “seguire” e “imitare” processi di ragionamento complessi emerge solo quando i modelli raggiungono una sufficiente capacità rappresentazionale.
Il CoT si è rivelato particolarmente efficace per tre categorie di problemi: ragionamento aritmetico (problemi matematici word problems), ragionamento di senso comune (task che richiedono inferenze sul mondo fisico e sociale), e ragionamento simbolico (manipolazione di simboli secondo regole). Per task più semplici che non richiedono ragionamento multi-step, il CoT non offre vantaggi e può anzi introdurre overhead computazionale non necessario.
Self-Consistency: Campionare Molteplici Percorsi
Nel marzo 2022, solo due mesi dopo il paper originale sul CoT, Xuezhi Wang, Jason Wei, Dale Schuurmans, Quoc Le, Ed Chi e Denny Zhou introdussero “Self-Consistency”, una strategia di decodifica che amplifica ulteriormente i benefici del CoT. L’intuizione di base è profonda: un problema di ragionamento complesso ammette tipicamente molteplici percorsi di pensiero validi che portano alla stessa risposta corretta.
Invece di generare un singolo chain of thought con decodifica greedy (scegliendo sempre il token più probabile), il metodo campiona un insieme diversificato di percorsi di ragionamento usando temperature più alta, poi seleziona la risposta finale che appare più frequentemente attraverso questi percorsi (marginalizzazione). Per esempio, il problema delle palline da tennis potrebbe essere risolto contando prima le nuove palline poi aggiungendole, oppure decomponendo in passi diversi – ma percorsi corretti convergeranno su “11”.
I risultati furono spettacolari: Self-Consistency aumentò le prestazioni di +17,9% su GSM8K (da 57% a 74,9% usando PaLM 540B), +11,0% su SVAMP (da 79,0% a 90,0%), e +12,2% su AQuA (da 36,8% a 49,0%). Il metodo è particolarmente robusto perché non richiede training addizionale, data annotation o modifiche all’architettura – solo inferenza multipla e un semplice voto a maggioranza.
Analisi qualitative hanno rivelato che il self-consistency filtra efficacemente errori di ragionamento: percorsi che commettono errori aritmetici o logici tendono a produrre risposte sparse e incoerenti, mentre percorsi corretti convergono. Questo crea un “ensemble di ragionamenti” che è più robusto dei singoli tentativi.
Varianti e Estensioni del CoT
Il successo del CoT ha scatenato un’esplosione di ricerca su varianti e estensioni:
Least-to-Most Prompting decompone problemi complessi in sotto-problemi più semplici, risolvendoli sequenzialmente e usando le soluzioni dei sotto-problemi per affrontare il problema completo. Questo approccio si è rivelato particolarmente efficace per problemi di ragionamento compositivo.
Tree-of-Thoughts generalizza il CoT a una struttura ad albero, dove ogni nodo rappresenta uno stato parziale del ragionamento e i rami rappresentano possibili passaggi successivi. Il modello può esplorare molteplici percorsi, fare backtracking quando necessario, e valutare stati intermedi per decidere quale percorso perseguire.
Program-Aided Language Models (PAL) combinano il ragionamento linguistico con l’esecuzione di codice: il modello genera programmi Python che risolvono i problemi, delegando il calcolo effettivo a un interprete. Questo riduce gli errori aritmetici e permette di gestire calcoli che sarebbero difficili per un modello puramente linguistico.
Automatic Chain-of-Thought (Auto-CoT) affronta il costo di creare manualmente esempi CoT di alta qualità. Il metodo campiona automaticamente esempi diversificati dal dataset, genera catene di pensiero usando zero-shot prompting con “Let’s think step by step”, e seleziona esempi di alta qualità basandosi su euristiche semplici. Auto-CoT raggiunge prestazioni comparabili al CoT manuale riducendo drasticamente lo sforzo umano.
Limiti Fondamentali e Criticità del CoT
Nonostante il successo empirico, ricerche recenti hanno rivelato limitazioni significative del CoT che sollevano questioni profonde sulla natura del ragionamento nei LLM.
CoT non è vera explainability: Studi di Miles Turpin et al. hanno dimostrato che i modelli possono produrre chain of thought “plausibili” ma inaffidabili. In esperimenti controllati, riordinare le opzioni in domande a scelta multipla portava i modelli a cambiare risposta ma a generare comunque CoT coerenti e convincenti per la nuova scelta – suggerendo che il modello usa percorsi computazionali interni non rivelati dai passaggi verbalizzati.
Ragionamento con dimostrazioni invalide: Wang et al. (2023) hanno mostrato un risultato sorprendente: il prompting con chain of thought contenenti passaggi di ragionamento invalidi o irrilevanti può comunque raggiungere l’80-90% delle prestazioni del CoT standard. Questo suggerisce che i benefici del CoT potrebbero derivare in parte semplicemente dall’aumentare lo “spazio di computazione” (più token generati prima della risposta finale) piuttosto che dal seguire genuinamente il ragionamento mostrato.
Bias e sensibilità al prompt: Il CoT eredita e può amplificare bias presenti negli esempi dimostrativi. Piccole variazioni nel fraseggio degli esempi possono portare a grandi variazioni nelle prestazioni. Inoltre, il CoT è vulnerabile a “shortcut reasoning”: il modello può identificare pattern superficiali negli esempi che non generalizzano.
Costi computazionali: Generare chain of thought aumenta significativamente il numero di token prodotti (spesso 5-10x rispetto alla risposta diretta), moltiplicando i costi di inferenza. Tecniche come self-consistency esacerbano questo problema richiedendo molteplici generazioni indipendenti.
Queste limitazioni hanno spinto ricerche su “Quiet-STaR” (self-taught reasoning) e altri approcci che tentano di rendere il ragionamento più genuinamente interno piuttosto che puramente linguistico-verbale. Rimane aperta la questione filosofica se il CoT rappresenta “ragionamento” autentico o piuttosto una forma sofisticata di pattern matching e interpolazione.
Mixture of Experts: Scalare l’Efficienza dei Transformer
Il Principio Fondamentale e le Origini
Mentre il Transformer risolveva il problema della parallelizzazione e delle dipendenze a lungo raggio, emergeva rapidamente un nuovo limite: per migliorare le prestazioni su task complessi, i modelli dovevano crescere in dimensione, ma questo rendeva sia il training che l’inferenza proibitivamente costosi oltre certe scale. Il Mixture of Experts (MoE) offre una soluzione elegante: invece di attivare tutti i parametri del modello per ogni input, si addestra un insieme di sotto-reti specializzate (“esperti”) e si attiva solo un sottoinsieme per ciascun esempio.
Il principio core è disaccoppiare la capacità del modello (numero totale di parametri) dalla computazione per esempio: la capacità scala linearmente con il numero di esperti, mentre la computazione per forward pass cresce sub-linearmente o rimane costante se si fissa il numero di esperti attivati. Questo permette modelli con trilioni di parametri che sono computazionalmente equivalenti a modelli densi molto più piccoli.
L’idea del MoE non era nuova nel 2017 – era stata esplorata già negli anni ’90 da Jordan e Jacobs per problemi di machine learning classico. Ma fu Noam Shazeer, uno degli otto autori del paper Transformer, che nello stesso 2017 pubblicò con Geoffrey Hinton, Jeff Dean e altri “Outrageously Large Neural Networks: The Sparsely-Gated Mixture-of-Experts Layer”, scalando l’approccio a un LSTM da 137 miliardi di parametri.
L’Architettura MoE nei Transformer
Nei moderni Transformer-based LLM, i layer MoE sono tipicamente inseriti al posto della rete feed-forward (FFN) in alcuni o tutti i blocchi Transformer. Ogni layer MoE contiene molteplici esperti (tipicamente reti feed-forward indipendenti, ciascuna con gli stessi input e output dimensions ma parametri distinti), un meccanismo di gating/routing (una funzione che decide quali esperti attivare per un dato input), e un sistema di combinazione degli output degli esperti selezionati usando i pesi del gating.
Il numero di esperti varia ampiamente: 8, 16, 64, 128, fino a 2048 in alcuni modelli. Il gating produce pesi per ciascun esperto, e solo i top-k esperti (spesso k=1 o k=2) vengono effettivamente computati. Con top-k gating, solo i k esperti con pesi più alti vengono computati, rendendo la computazione sparsa e molto più efficiente.
Le Sfide del Training MoE
Il training dei MoE presenta sfide uniche che non esistono nei modelli densi:
Load balancing: Senza vincoli, il gating network tende a collassare verso l’uso di pochi esperti preferiti, lasciando gli altri sottoutilizzati. Questo spreca capacità e può portare a instabilità. La soluzione standard è aggiungere una auxiliary loss che penalizza lo sbilanciamento, incoraggiando distribuzione uniforme del carico. Bilanciare efficacia (lasciare che il gating scelga liberamente) e efficienza (assicurare uso uniforme) richiede tuning attento.
Comunicazione tra dispositivi: Nel training distribuito, esperti diversi risiedono spesso su dispositivi diversi. Il routing dinamico richiede comunicazione all-to-all tra dispositivi per inviare ciascun token all’esperto appropriato, creando overhead significativo. Tecniche moderne come “Expert Parallelism” e buffer di capacità limitata mitigano questo problema.
Instabilità di training: I modelli MoE sono notoriamente difficili da stabilizzare durante il training. Piccole variazioni nei pesi del gating possono causare grandi cambiamenti nel routing, creando dinamiche caotiche nei gradienti. L’uso di dropout più basso, inizializzazione attenta dei parametri di gating, e gradient clipping aggressivo si sono rivelati essenziali.
Switch Transformers: Semplificare il MoE
Nel 2021, William Fedus, Barret Zoph, Noam Shazeer e altri di Google pubblicarono “Switch Transformers: Scaling to Trillion Parameter Models with Simple and Efficient Sparsity”, che affrontò molte delle instabilità dei MoE precedenti. L’innovazione chiave fu contro-intuitiva: invece di usare top-k con k≥2 esperti come nei lavori precedenti, Switch Transformers adottò una strategia semplificata con singolo esperto attivo (k=1).
Questa scelta ha molteplici vantaggi: throughput di training aumentato (routing verso un singolo esperto riduce comunicazione e computation overhead), parametri sparser (meno della metà dei parametri attivati rispetto a top-2), e semplicità (elimina la necessità di combinare ponderando output di esperti multipli).
Per compensare la ridotta capacità per token, Switch Transformers aumentò drasticamente il numero di esperti: il modello più grande conteneva 1,6 trilioni di parametri con 2048 esperti distribuiti su 2048 TPU cores. Nonostante le dimensioni, raggiunsero un’accelerazione 4x nel pre-training rispetto a T5-XXL denso, mantenendo o superando le prestazioni.
Switch Transformers introdusse anche tecniche di stabilizzazione cruciali: bfloat16 precision per rappresentare i logit del router (invece di float32), selective precision per computazioni critiche, e smaller parameter initialization per i pesi del router. Queste modifiche permisero training stabile anche a scale di trilioni di parametri.
Sviluppi Recenti e Architetture Ibride (2023-2025)
La ricerca post-2021 ha esplorato direzioni diverse per migliorare efficienza e flessibilità dei MoE:
Router adattivi e condizionali: Invece di routing statico basato solo sull’input corrente, approcci come “Adaptive MoE” considerano il contesto della sequenza e adattano dinamicamente il numero di esperti attivati in base alla difficoltà dell’input. Token “semplici” potrebbero usare un solo esperto, mentre token ambigui o complessi attivano multipli esperti.
Expert merging e pruning: Tecniche come “Branch-Train-MiX” addestrano esperti separati su domini specializzati (es. matematica, codice, linguaggio naturale) poi li combinano in un singolo modello. Durante inferenza, il routing può selezionare gli esperti appropriati per il task. Il “merging” di esperti simili riduce ridondanza mantenendo le prestazioni.
Fine-grained MoE: Invece di sostituire intere FFN con MoE, architetture recenti applicano MoE a livello più granulare – ad esempio, solo alle porzioni di up-projection o down-projection della FFN. Questo offre un trade-off intermedio tra densità e sparsità.
MoE con Transformer decoder-only: Mentre i primi MoE si concentravano su architetture encoder-decoder per traduzione, modelli recenti come Mixtral 8x7B di Mistral AI dimostrano che MoE funziona eccellentemente in architetture decoder-only stile GPT. Mixtral raggiunge prestazioni comparabili o superiori a modelli densi molto più grandi con costi di inferenza drasticamente ridotti.
Dense-to-Sparse training: Approcci come “Sparse Upcycling” iniziano con un modello denso pre-trained, poi lo convertono in MoE inizializzando molteplici esperti come copie della FFN originale. Questo permette di sfruttare checkpoint densi esistenti e riduce il training time necessario per il MoE.
Distillazione e Deployment
Un’applicazione pratica particolarmente interessante è la distillazione di MoE in modelli densi. Dopo aver pre-training un grande modello MoE, si può addestrare un modello denso più piccolo a imitarne gli output. Sorprendentemente, questo modello distillato può mantenere il 30-40% dei guadagni di prestazione del MoE pur avendo dimensioni drasticamente ridotte. Questo offre il meglio di entrambi i mondi: training efficiente con MoE sparso, deployment con modello denso più piccolo.
Durante l’inferenza, i MoE presentano caratteristiche uniche: la latenza è determinata dal numero di esperti attivati (k), non dal numero totale, ma il throughput può essere limitato dal load balancing – se molti esempi in un batch vengono instradati allo stesso esperto, si crea un collo di bottiglia. Tecniche moderne di batching dinamico e “expert buffering” mitigano questi problemi.
Applicazioni Multilingue e Multi-Task
I MoE brillano particolarmente in contesti multilingue, dove diversi esperti possono specializzarsi in famiglie linguistiche diverse. Analisi dei pattern di routing in modelli MoE multilingue hanno rivelato che, senza supervisione esplicita, gli esperti tendono a clusterizzare per similarità linguistica: un esperto potrebbe specializzarsi in lingue romanze, un altro in lingue slave, ecc.
Similmente, in setting multi-task, il MoE permette al modello di mantenere capacità specializzate per task diversi senza interferenza catastrofica. Questo è particolarmente rilevante per modelli “generalist” che devono eccellere simultaneamente in matematica, codice, ragionamento di senso comune, creatività letteraria, ecc.
Prospettive Future e Limiti Aperti
Nonostante i progressi, sfide significative rimangono:
Bilanciamento senza auxiliary losses: Le loss ausiliarie per load balancing introducono iperparametri sensibili e possono confliggere con l’obiettivo primario. Approcci emergenti esplorano constraint impliciti o architetture self-balancing.
Routing interpretabile: Capire perché certi input vengono instradati a certi esperti rimane largamente opaco. Migliorare l’interpretabilità potrebbe permettere controllo più fine e debugging efficace.
MoE oltre il linguaggio: Estendere MoE a modalità multimodali (vision-language, audio) e a architetture diverse dai Transformer (State Space Models, modelli basati su retrieval) è area di ricerca attiva.
Efficienza hardware: Le GPU e TPU moderne sono ottimizzate per operazioni dense. Sfruttare pienamente la sparsità del MoE richiede hardware specializzato o software altamente ottimizzato.
Il MoE rappresenta una delle direzioni più promettenti per continuare a scalare i modelli AI in modo sostenibile, permettendo capacità crescenti senza crescita proporzionale nei costi computazionali – una sfida fondamentale nell’era dei foundation models.
L’Eredità e l’Impatto Duraturo
“Attention Is All You Need” non è stato solo un paper tecnico di successo, ma ha rappresentato un vero cambio di paradigma che ha ridefinito l’intero campo del natural language processing e oltre. L’architettura Transformer è ora ubiqua: BERT (2018), GPT (2018-2024), T5, BART, Vision Transformers per computer vision, AlphaFold2 per protein folding, DALL-E e Stable Diffusion per generazione di immagini, Whisper per speech recognition – tutti discendono direttamente dal paper del 2017.
Le innovazioni successive come Chain-of-Thought e Mixture of Experts non sostituiscono il Transformer ma lo estendono, affrontando limitazioni specifiche (capacità di ragionamento e scalabilità computazionale rispettivamente) mentre mantengono l’architettura fondamentale intatta. Questa stabilità architettonica è notevole in un campo che evolve rapidamente: mentre molti paradigmi AI hanno cicli di vita di pochi anni prima di essere soppiantati, il Transformer rimane dominante otto anni dopo la sua introduzione.
Il vero genio del paper fu riconoscere che l’attenzione poteva essere sufficiente – che l’eleganza e la parallelizzabilità del meccanismo di attenzione superavano la complessità sequenziale delle architetture precedenti. Questa intuizione, inizialmente accolta con scetticismo persino da esperti del campo, ha resistito alla prova del tempo e della scala, dimostrando che a volte le soluzioni più potenti sono anche le più concettualmente pure.
Il presente articolo ha carattere generale e informativo, non costituisce parere legale personalizzato e non sostituisce la consulenza diretta con un notaio. Per assistenza specifica relativa alla vostra situazione, vi invitiamo a contattare il nostro Studio per fissare un appuntamento. Contenuto generato con sistemi di Intelligenza Artificiale e supervisionato da professionisti dello Studio Notarile, in conformità ai requisiti di trasparenza del Regolamento UE 2024/1689 (AI Act).