
 Da Manlio Carlo Soldani
Di Manlio Carlo Soldani, Notaio in Domodossola
Indice dei contenuti
Introduzione: Un Paper che Ha Cambiato il Mondo
Il 12 dicembre 2017, un gruppo di ricercatori di Google Brain e Google Research, guidato da Ashish Vaswani, pubblicò sulla piattaforma arXiv un paper destinato a diventare uno dei lavori scientifici più influenti della storia dell’intelligenza artificiale. Il titolo, apparentemente criptico, “Attention Is All You Need”, nascondeva una rivoluzione concettuale che avrebbe trasformato non solo il natural language processing, ma l’intera architettura dei moderni sistemi di intelligenza artificiale.
Oggi, nel 2026, mentre utilizziamo quotidianamente ChatGPT, Claude, Gemini e altri assistenti AI, raramente ci soffermiamo a riflettere sulle fondamenta tecnologiche che rendono possibili queste interazioni. Come notai, professionisti abituati a risalire alle fonti normative e giurisprudenziali, dobbiamo applicare lo stesso rigore metodologico agli strumenti tecnologici che stanno trasformando la nostra professione.
Questo articolo si propone di analizzare in profondità l’architettura Transformer introdotta da Vaswani e colleghi, tracciare l’evoluzione dei Large Language Models che ne sono derivati, ed esaminare le tappe fondamentali che hanno condotto all’attuale stato dell’arte, con particolare attenzione a due innovazioni cruciali: il Chain of Thought prompting e l’architettura Mixture of Experts.
La Fonte: Vaswani et al. e il Paper Originale
Citazione completa: Vaswani, A., Shazeer, N., Parmar, N., Uszkoreit, J., Jones, L., Gomez, A. N., Kaiser, Ł., & Polosukhin, I. (2017). Attention is all you need. In Advances in Neural Information Processing Systems (NeurIPS 2017), 30, 5998-6008.
Il paper è disponibile integralmente su arXiv (https://arxiv.org/abs/1706.03762) e rappresenta, con oltre 100.000 citazioni nella letteratura scientifica, uno dei lavori più referenziati nella storia del machine learning. Gli autori, un team di ricercatori che includeva alcune delle menti più brillanti di Google (tra cui Noam Shazeer e Jakob Uszkoreit), stavano affrontando un problema apparentemente tecnico: come migliorare la traduzione automatica.
La soluzione che proposero andò ben oltre il problema originale, creando un’architettura di rete neurale che si sarebbe rivelata applicabile a qualsiasi compito che coinvolgesse sequenze di dati, dal testo alle immagini, dall’audio al codice informatico.
Il Contesto Pre-Transformer: I Limiti delle Architetture Ricorrenti
Per comprendere la portata rivoluzionaria del Transformer, dobbiamo prima esaminare lo stato dell’arte precedente al 2017.
Prima di Vaswani e colleghi, l’elaborazione del linguaggio naturale si basava principalmente su architetture ricorrenti, in particolare le Recurrent Neural Networks (RNN) e le loro varianti più sofisticate: Long Short-Term Memory (LSTM) e Gated Recurrent Units (GRU). Queste architetture erano state introdotte negli anni ’90 e perfezionate nel corso dei decenni successivi, in particolare da Jürgen Schmidhuber e dai suoi collaboratori.
Il principio fondamentale delle RNN era l’elaborazione sequenziale: la rete processava il testo parola dopo parola, mantenendo uno “stato nascosto” che teoricamente conservava l’informazione su ciò che era stato letto fino a quel momento. È come se un notaio leggesse un contratto dall’inizio alla fine, cercando di ricordare tutto ciò che ha letto per comprendere ciascuna nuova clausola nel contesto di quelle precedenti.
Questo approccio presentava tre problemi fondamentali. Primo, l’elaborazione sequenziale impediva la parallelizzazione: ogni parola doveva attendere che la precedente fosse stata processata, rendendo l’addestramento su grandi dataset estremamente lento. Secondo, le RNN soffrivano del cosiddetto “vanishing gradient problem”: l’informazione relativa a parole lontane nel testo tendeva a svanire, rendendo difficile cogliere dipendenze a lungo raggio. Terzo, anche le versioni più sofisticate come le LSTM, pur mitigando questi problemi, rimanevano computazionalmente inefficienti e difficili da scalare.
Il meccanismo di attention, introdotto nel 2014 da Bahdanau, Cho e Bengio nel contesto della traduzione neurale, aveva iniziato a mostrare una via d’uscita: permettere alla rete di “guardare indietro” a parti specifiche dell’input quando genera ciascun elemento dell’output. Tuttavia, l’attention era ancora utilizzato come complemento alle RNN, non come loro sostituto.
L’Innovazione Transformer: Architettura e Meccanismi
L’intuizione rivoluzionaria di Vaswani e colleghi fu di eliminare completamente la ricorrenza e basare l’intera architettura esclusivamente sul meccanismo di attention. Da qui il titolo del paper: “Attention Is All You Need” – l’attention è tutto ciò di cui hai bisogno.
Il Meccanismo di Self-Attention
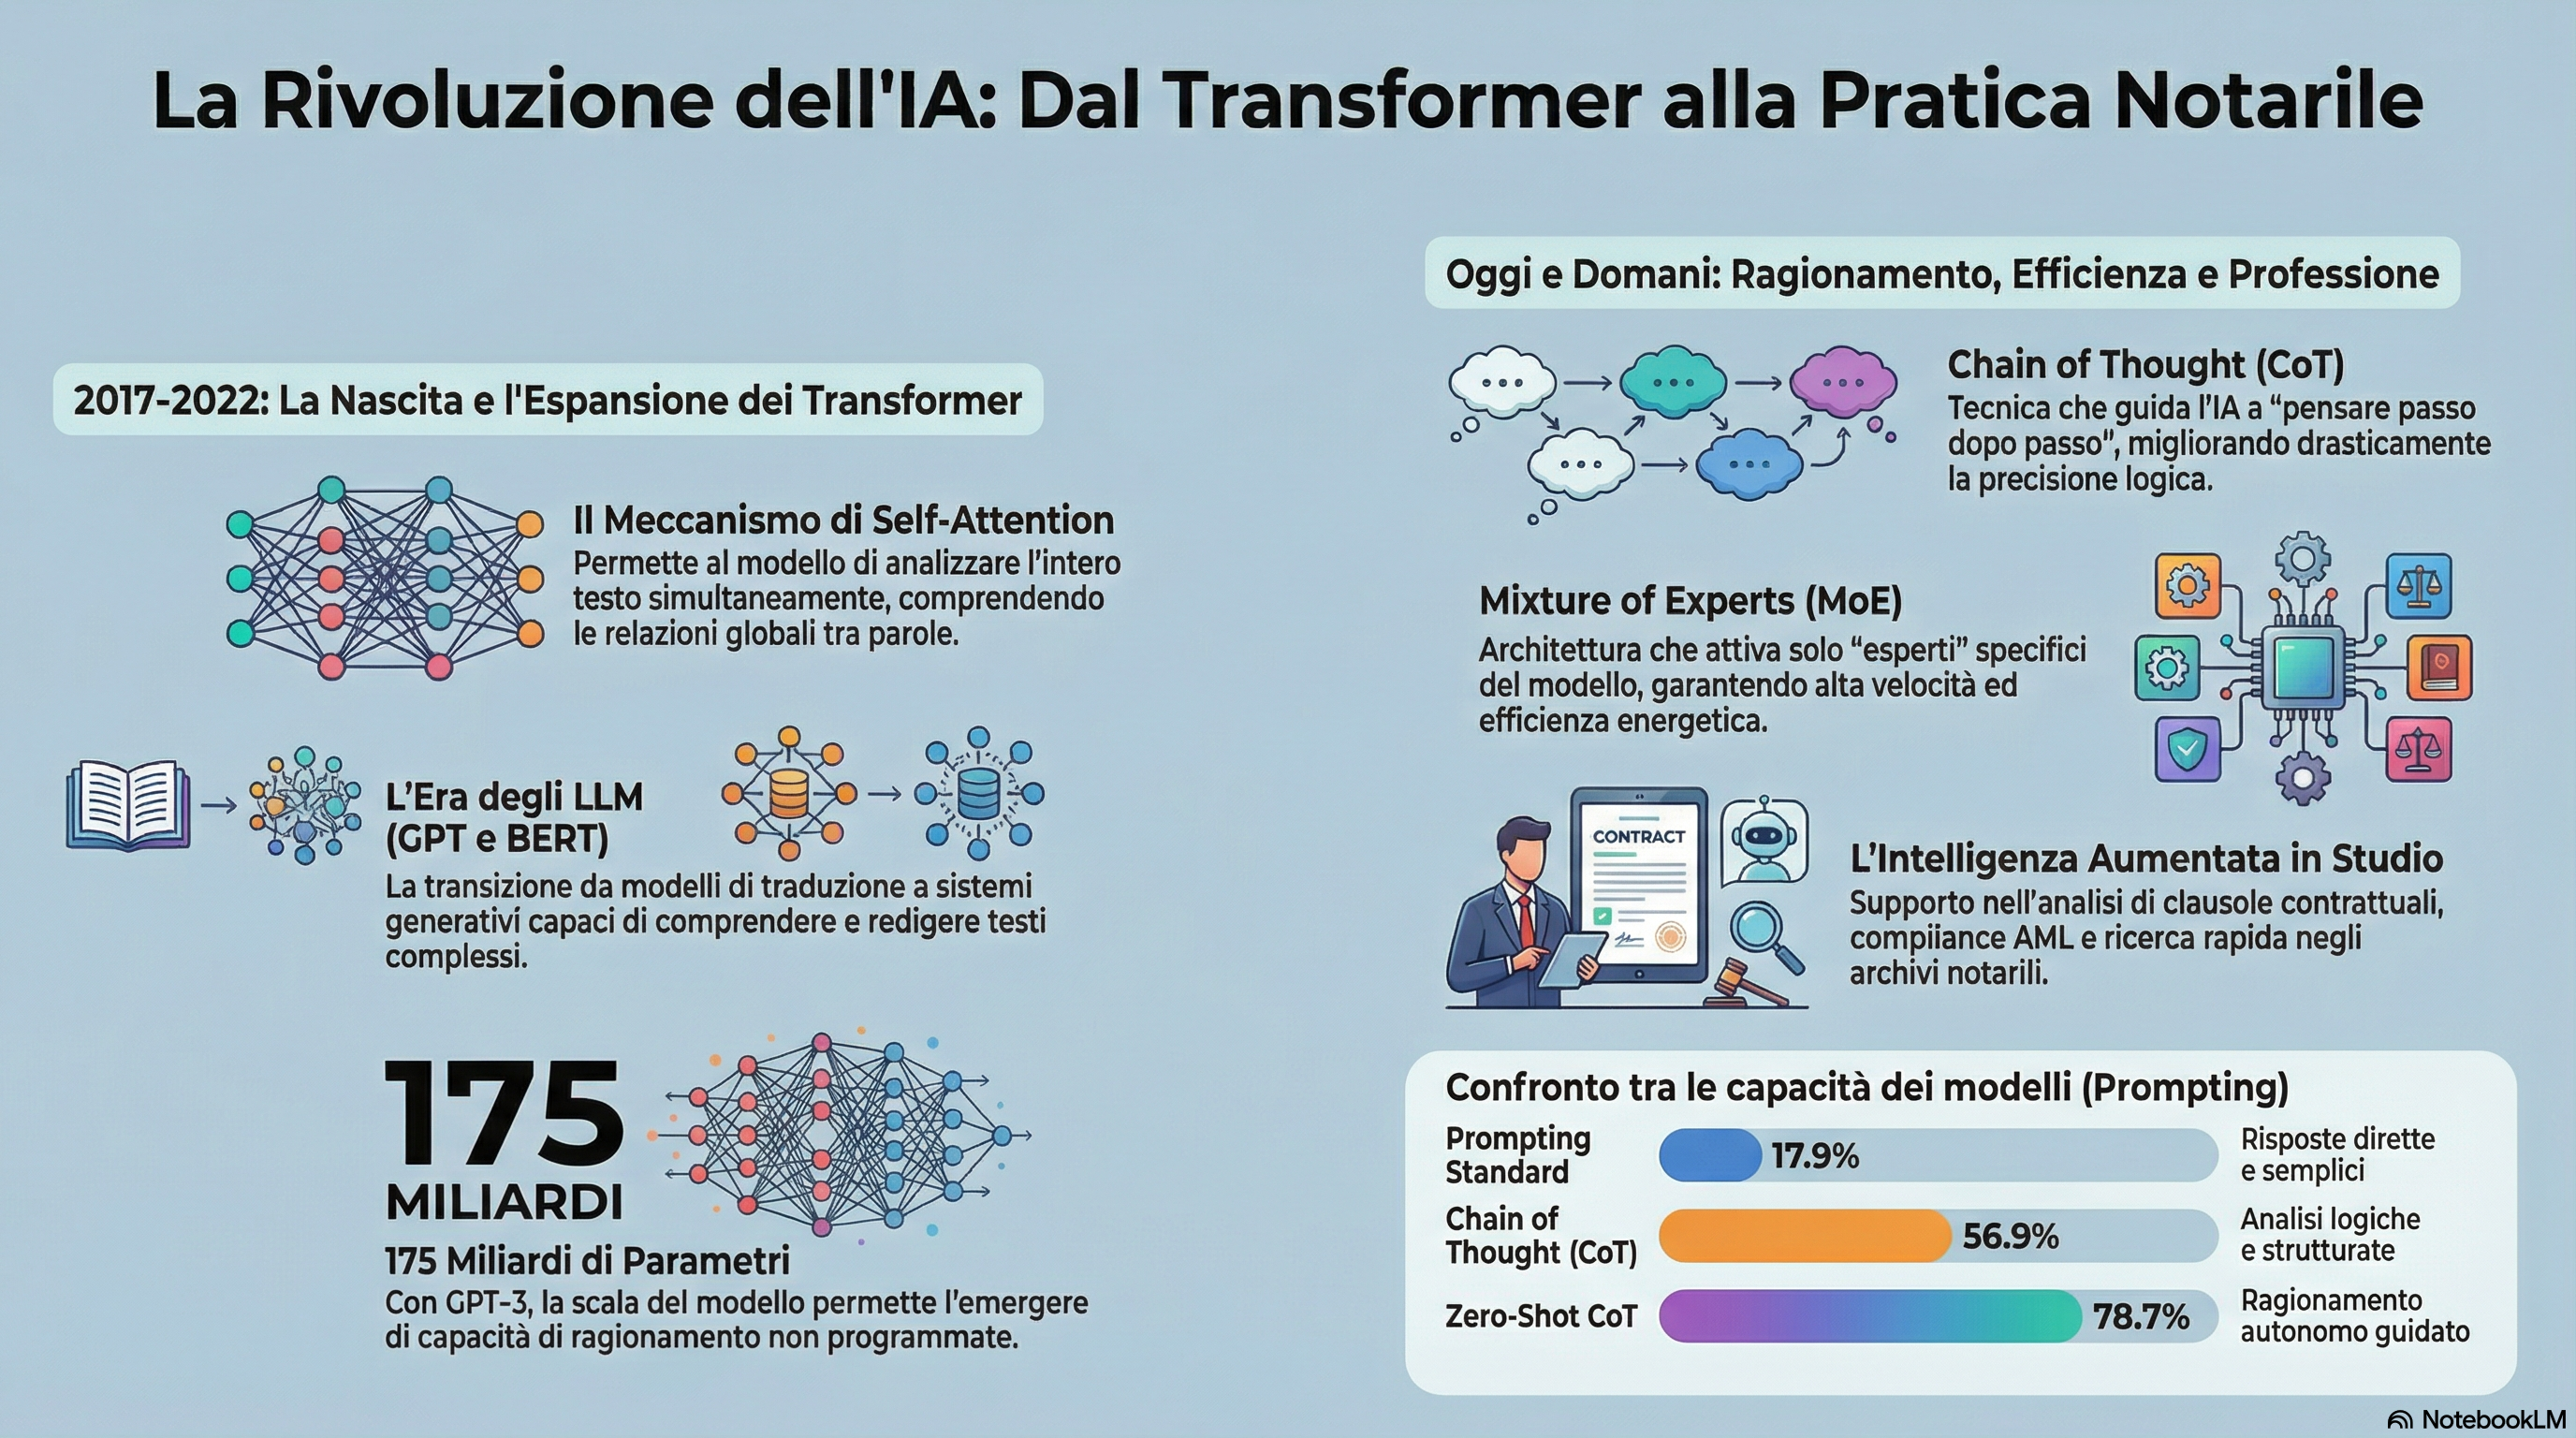
Il cuore del Transformer è il meccanismo di self-attention, che permette al modello di valutare simultaneamente tutte le posizioni di una sequenza quando processa ciascun elemento. Per comprendere questo concetto, consideriamo un atto notarile complesso.
Un notaio esperto, leggendo la clausola dispositiva di un contratto, tiene mentalmente presente non solo il testo immediatamente precedente, ma anche le premesse iniziali, le dichiarazioni delle parti, eventuali clausole di garanzia già lette, e persino clausole successive che ha già scorso rapidamente. La sua comprensione di ciascuna parola è informata da una visione globale del documento.
Il self-attention replica computazionalmente questo processo. Per ogni parola (tecnicamente, ogni “token”) nella sequenza, il meccanismo calcola quanto quella parola dovrebbe “prestare attenzione” a tutte le altre parole, inclusa se stessa. Questo avviene attraverso tre trasformazioni lineari che generano query, chiavi e valori (Query, Key, Value).
Matematicamente, il self-attention può essere espresso come:
Attention(Q, K, V) = softmax(QK^T / √d_k)V
dove Q rappresenta le query, K le chiavi, V i valori, e d_k è la dimensionalità delle chiavi. Questa formula permette al modello di calcolare punteggi di rilevanza tra tutte le coppie di token, pesare di conseguenza i valori, e produrre rappresentazioni contestualizzate per ciascuna posizione.
Multi-Head Attention: Prospettive Multiple
Una singola operazione di attention potrebbe concentrarsi su un unico tipo di relazione tra le parole. Il Transformer introduce il concetto di “multi-head attention”: invece di calcolare l’attention una sola volta, lo calcola più volte in parallelo (nel modello originale, 8 volte), ciascuna con parametri diversi.
Questo è analogo ad avere diversi esperti che leggono lo stesso contratto con focus diversi: uno si concentra sulle relazioni sintattiche, un altro sui collegamenti semantici, un terzo sulle dipendenze temporali, e così via. Le rappresentazioni prodotte da queste “teste” vengono poi concatenate e trasformate linearmente per produrre l’output finale.
Positional Encoding: Preservare l’Ordine
Eliminando la ricorrenza, il Transformer perde intrinsecamente la nozione di ordine sequenziale. Per reintrodurre questa informazione cruciale, gli autori proposero il positional encoding: funzioni sinusoidali di diverse frequenze che vengono sommate alle rappresentazioni dei token, permettendo al modello di distinguere la posizione di ciascuna parola nella sequenza.
Architettura Encoder-Decoder
Il Transformer originale seguiva un’architettura encoder-decoder. L’encoder, composto da 6 layer identici, processa l’intera sequenza di input producendo rappresentazioni contestualizzate. Ciascun layer contiene un meccanismo di multi-head self-attention seguito da una feed-forward network. Il decoder, anch’esso con 6 layer, genera l’output token per token, utilizzando sia il self-attention (mascherato per garantire che la predizione di ciascun token dipenda solo dai token precedenti) sia un attention “incrociato” che permette di attendere all’output dell’encoder.
La Nascita degli LLM: Da Transformer a GPT, BERT e Oltre
L’architettura Transformer, inizialmente proposta per la traduzione automatica, si rivelò straordinariamente versatile. Nel giro di pochi mesi, due linee di ricerca parallele dimostrarono che il Transformer poteva essere la base per modelli linguistici di portata generale.
GPT: La Linea Decoder-Only
Nel giugno 2018, pochi mesi dopo la pubblicazione di “Attention Is All You Need”, OpenAI pubblicò il primo Generative Pre-trained Transformer (GPT). L’intuizione chiave fu di utilizzare solo la parte decoder del Transformer, eliminando l’encoder.
Perché questa scelta? I ricercatori di OpenAI, guidati da Alec Radford, si resero conto che per il language modeling generativo – predire la prossima parola data una sequenza – non era necessaria la complessità dell’architettura encoder-decoder. Un decoder-only transformer, addestrato su enormi quantità di testo con l’obiettivo di predire la parola successiva, poteva imparare rappresentazioni linguistiche generalizzabili.
GPT-1 aveva “solo” 117 milioni di parametri e fu addestrato su un corpus di 7.000 libri (circa 5GB di testo). Nonostante le dimensioni modeste per gli standard odierni, GPT-1 dimostrò un principio fondamentale: un modello pre-addestrato su grandi quantità di testo poteva poi essere fine-tuned per compiti specifici con relativa facilità.
BERT: La Rivoluzione Bidirezionale
Nell’ottobre 2018, Google pubblicò BERT (Bidirectional Encoder Representations from Transformers), un modello che adottava l’approccio opposto: utilizzare solo la parte encoder del Transformer.
L’innovazione di BERT stava nel suo obiettivo di addestramento: il Masked Language Modeling (MLM). Invece di predire la prossima parola in modo autoregressivo (come GPT), BERT nasconde casualmente il 15% delle parole in una frase e addestra il modello a predirle basandosi sia sul contesto precedente che su quello successivo. Questo addestramento bidirezionale permette a BERT di sviluppare una comprensione più profonda del contesto.
BERT fu addestrato su BookCorpus (800M parole) e Wikipedia inglese (2.500M parole), e venne rilasciato in diverse dimensioni: BERT-Base (110M parametri) e BERT-Large (340M parametri). I risultati furono straordinari: BERT stabilì nuovi record in 11 task di natural language processing, dimostrando la potenza dell’approccio encoder-only per compiti di comprensione del linguaggio.
Per un notaio, la differenza tra GPT e BERT è simile alla differenza tra redigere un nuovo documento (GPT, generativo) e analizzare un documento esistente per estrarne informazioni (BERT, comprensione). Entrambe le capacità sono essenziali, ma richiedono approcci diversi.
T5: Il Paradigma Text-to-Text
Nel 2020, Google introdusse T5 (Text-to-Text Transfer Transformer), che rappresentò una sintesi concettuale delle architetture precedenti. T5 tornava all’architettura encoder-decoder completa del Transformer originale, ma con un’idea unificante: trattare ogni task di NLP come un problema di conversione da testo a testo.
Traduzione? Input: “translate English to German: Hello” → Output: “Hallo”. Classificazione di sentiment? Input: “sentiment: This movie is great” → Output: “positive”. Summarization? Input: “summarize: [long text]” → Output: “[summary]”.
Questo approccio elegante permette di utilizzare la stessa architettura e lo stesso paradigma di addestramento per compiti estremamente diversi. T5 fu addestrato sul Colossal Clean Crawled Corpus (C4), un dataset di 750GB derivato dalla pulizia aggressiva di 20TB di dati da Common Crawl, e venne rilasciato in diverse dimensioni, fino a T5-11B con 11 miliardi di parametri.
GPT-2, GPT-3 e la Scala Come Paradigma
Nel febbraio 2019, OpenAI rilasciò GPT-2, scalando l’architettura a 1.5 miliardi di parametri e addestrando su WebText, un dataset di 40GB. GPT-2 dimostrò capacità emergenti sorprendenti: poteva generare testo coerente su argomenti diversi, tradurre, rispondere a domande, senza essere stato specificamente addestrato per questi compiti.
Ma fu GPT-3, rilasciato nel maggio 2020, a segnare un punto di svolta. Con 175 miliardi di parametri, addestrato su circa 500 miliardi di token, GPT-3 dimostrò la capacità di “in-context learning”: fornendo pochi esempi di un task nel prompt, il modello poteva eseguire quel task senza alcun fine-tuning dei suoi parametri. Questo shift dal paradigma “pre-train + fine-tune” al paradigma “pre-train + prompt” rappresentò una trasformazione fondamentale nel modo di utilizzare i LLM.
GPT-3 fu anche il primo modello a dimostrare chiaramente che molte capacità emergono solo oltre una certa scala. Compiti di ragionamento complesso, aritmetica multi-step, e comprensione contestuale profonda apparivano solo in modelli con decine o centinaia di miliardi di parametri – un fenomeno noto come “emergent abilities”.
L’Evoluzione Continua: Da GPT-3.5 a GPT-4 e Oltre
GPT-3.5, rilasciato nel 2022, introdusse l’instruction tuning e il Reinforcement Learning from Human Feedback (RLHF), tecniche che permisero di allineare meglio il comportamento del modello alle intenzioni degli utenti. Questa versione fu la base per ChatGPT, lanciato nel novembre 2022, che democratizzò l’accesso agli LLM portandoli all’attenzione del grande pubblico.
GPT-4, rilasciato nel marzo 2023, rappresentò un ulteriore salto qualitativo, introducendo capacità multimodali (testo e immagini) e migliorando sostanzialmente performance su task di ragionamento, matematica e programmazione. Contemporaneamente, altri player entrarono nell’arena: Google con PaLM (540B parametri) e successivamente Gemini, Anthropic con Claude, Meta con LLaMA, Mistral AI con la serie Mistral, e molti altri.
Ciascuno di questi modelli, pur basandosi sull’architettura Transformer fondamentale, introduce variazioni architetturali, tecniche di addestramento e ottimizzazioni specifiche. Quello che è rimasto costante è il principio di base introdotto da Vaswani et al.: l’attention come meccanismo fondamentale per processare sequenze.
Chain of Thought: Insegnare il Ragionamento Step-by-Step
Una delle limitazioni più evidenti dei primi LLM era la loro difficoltà con compiti che richiedono ragionamento multi-step. Problemi di aritmetica anche semplici, puzzle logici, o ragionamenti che richiedono più passaggi intermedi spesso producevano risposte errate.
L’Intuizione di Wei et al.
Nel gennaio 2022, Jason Wei e colleghi (inclusi ricercatori di Google Brain e OpenAI) pubblicarono il paper “Chain-of-Thought Prompting Elicits Reasoning in Large Language Models”, introducendo una tecnica sorprendentemente semplice ma efficace.
L’idea centrale è che mostrando al modello esempi dove il ragionamento è esplicitato step-by-step, il modello impara a replicare questo processo di decomposizione quando affronta problemi simili. Invece di chiedere semplicemente “Quanto fa 15 × 23?”, si forniscono esempi del tipo:
“Domanda: Quante mele ho se ne compro 12, ne regalo 5, ne compro altre 8 e ne mangio 3?
Ragionamento: Comincio con 12 mele. Dopo averne regalate 5, ho 12 – 5 = 7 mele. Compro altre 8, quindi 7 + 8 = 15 mele. Mangio 3 mele, quindi 15 – 3 = 12 mele.
Risposta: 12 mele.”
Fornendo alcuni esempi di questo tipo (tipicamente 5-8), il modello, quando affronta una nuova domanda simile, produce spontaneamente un ragionamento articolato prima di dare la risposta finale.
Risultati e Capacità Emergenti
Gli esperimenti dimostrarono miglioramenti drammatici. Su GSM8K, un benchmark di problemi matematici per scuole elementari, PaLM-540B passò dal 17.9% di accuratezza con prompting standard al 56.9% con Chain of Thought prompting. Su SVAMP (problemi aritmetici con variazioni), l’accuratezza passò dal 72.9% all’89.0%.
Curiosamente, Chain of Thought risultò efficace solo con modelli molto grandi (oltre 100 miliardi di parametri). Con modelli più piccoli, il tentativo di generare ragionamenti step-by-step portava spesso a “catene di pensiero” illogiche che peggioravano le performance rispetto al prompting standard.
Zero-Shot Chain of Thought
Un’evoluzione ulteriore venne proposta da Kojima et al. nel maggio 2022: il Zero-Shot Chain of Thought. L’idea è ancora più semplice: invece di fornire esempi di ragionamento, basta aggiungere al prompt la frase “Let’s think step by step” (“Pensiamo passo per passo”).
Questa tecnica, sorprendentemente efficace, funziona in due fasi. Prima, il modello viene invitato a generare il ragionamento (“Let’s think step by step” dopo la domanda). Poi, il ragionamento generato viene utilizzato come contesto per estrarre la risposta finale. Su MultiArith, InstructGPT (text-davinci-002) passò dal 17.7% di accuratezza con prompting standard al 78.7% con Zero-Shot CoT.
Implicazioni per la Pratica Notarile
Per i notai, Chain of Thought prompting offre un paradigma per interagire con gli LLM in modo più efficace quando si affrontano analisi complesse. Invece di chiedere “Questo contratto presenta rischi fiscali?”, possiamo strutturare il prompt come: “Analizza questo contratto passo per passo: (1) identifica le parti e i loro obiettivi, (2) esamina la struttura giuridica proposta, (3) valuta le implicazioni fiscali di ciascun elemento, (4) sintetizza i rischi complessivi.”
Questo approccio produce output più strutturati, verificabili e affidabili. Il “ragionamento esplicito” del modello ci permette anche di identificare eventuali errori nel processo di analisi, piuttosto che trovarci di fronte a una conclusione non motivata.
Mixture of Experts: Scalare l’Efficienza
Il secondo grande avanzamento architetturale post-Transformer è rappresentato dai modelli Mixture of Experts (MoE), che affrontano un problema fondamentale: come continuare a scalare i modelli senza rendere il training e l’inferenza computazionalmente proibitivi.
Il Concetto di MoE
L’idea di Mixture of Experts non è nuova in machine learning – fu proposta già nel 1991 da Jacobs et al. – ma la sua applicazione ai Transformer su larga scala è recente. Il principio è elegante: invece di avere un singolo grande modello monolitico, si hanno molti modelli più piccoli (“esperti”) e un meccanismo di routing che decide quali esperti attivare per ciascun input.
In un Transformer standard, ogni layer contiene un feed-forward network (FFN) attraverso cui passa ogni token. In un Transformer MoE, questo FFN viene sostituito con un layer MoE contenente multipli “esperti” (ciascuno un FFN), più un “gate” o “router” che decide quali esperti utilizzare.
Sparsità e Efficienza
Il vantaggio cruciale è la sparsità: per ogni input, solo un piccolo sottoinsieme di esperti viene attivato. Ad esempio, in un modello con 8 esperti dove il router seleziona i top-2, solo il 25% degli esperti è attivo per ciascun token. Questo permette di avere modelli con un numero totale di parametri molto più grande senza aumentare proporzionalmente il costo computazionale.
Consideriamo Mixtral 8x7B di Mistral AI, rilasciato nel dicembre 2023. Il modello ha 8 esperti da 7 miliardi di parametri ciascuno, per un totale di 46.7 miliardi di parametri. Tuttavia, per ogni token vengono attivati solo 2 esperti, rendendo il costo computazionale comparabile a un modello di 12-13 miliardi di parametri. Le performance, invece, sono competitive con modelli molto più grandi come GPT-3.5.
Routing e Specializzazione
Come funziona il router? Nel caso più semplice, è una rete neurale che prende come input la rappresentazione di un token e produce una distribuzione di probabilità sugli esperti. I top-K esperti (dove K è un iperparametro, spesso 1 o 2) vengono selezionati, i loro output vengono combinati con una somma pesata usando le probabilità del router, e il risultato viene passato al layer successivo.
Una domanda affascinante è: cosa imparano gli esperti? Si specializzano su domini semantici (uno per testi legali, uno per scientifici, uno per conversazioni informali)? O su funzioni linguistiche (sintassi, semantica, pragmatica)? Le evidenze sperimentali suggeriscono una specializzazione emergente, ma i pattern non sono sempre facilmente interpretabili dagli umani.
Sviluppi Recenti: GShard, Switch Transformer, DeepSeek
Google introdusse GShard nel 2020, un modello di traduzione che scala fino a 600 miliardi di parametri usando MoE con fino a 64 esperti per layer. Nel 2021, Google rilasciò Switch Transformers, che usava una versione semplificata con routing top-1 e raggiunse 1.6 trilioni di parametri.
Un recente esempio significativo è DeepSeek-v3, rilasciato nel gennaio 2025. Questo modello utilizza un’architettura MoE con 671 miliardi di parametri totali, di cui 37 miliardi attivi per token. DeepSeek-v3 ha dimostrato performance competitive con GPT-4 su molti benchmark, pur essendo open-source e richiedendo risorse computazionali significativamente inferiori.
Sfide e Limitazioni
I modelli MoE non sono privi di sfide. Il load balancing – assicurare che gli esperti siano utilizzati in modo equilibrato – è cruciale: se il router impara a usare sempre gli stessi pochi esperti, gli altri diventano inutili e si perde il vantaggio della sparsità. Tecniche di auxiliary loss sono usate per incentivare il bilanciamento.
La memoria è un’altra sfida: anche se durante l’inferenza solo una frazione degli esperti è attiva, tutti i parametri devono essere caricati in memoria. Questo rende i modelli MoE particolarmente impegnativi da deployare su hardware con memoria limitata.
L’Ecosistema Contemporaneo: Modelli Proprietari e Open Source
L’ecosistema degli LLM nel 2026 è caratterizzato dalla coesistenza di modelli proprietari di grandi organizzazioni (OpenAI, Anthropic, Google, Microsoft) e di un fiorente movimento open source.
Modelli Proprietari
OpenAI con GPT-4 e successive iterazioni, Anthropic con Claude (ora alla versione 4.5), Google con Gemini, hanno stabilito lo stato dell’arte in termini di capacità, ma mantengono i dettagli architetturali e i pesi dei modelli privati. Questi modelli sono accessibili tramite API commerciali.
Il Movimento Open Source
Meta con LLaMA (rilasciato inizialmente nel febbraio 2023 e successivamente nelle versioni LLaMA 2 e 3), Mistral AI con la serie Mistral e Mixtral, Stability AI, EleutherAI, e molti altri hanno rilasciato modelli con pesi accessibili pubblicamente. Questo ha democratizzato l’accesso agli LLM, permettendo ricerca indipendente, fine-tuning personalizzato, e deployment on-premise per applicazioni che richiedono privacy o compliance normativa.
Per il settore legale e notarile, i modelli open source offrono vantaggi specifici: la possibilità di addestrarli su corpus giuridici specializzati, di verificarne il comportamento in dettaglio, e di garantire che i dati dei clienti non lascino mai l’infrastruttura controllata dallo studio.
Implicazioni per la Professione Notarile
Come si collega tutto questo alla pratica notarile quotidiana? Le applicazioni sono molteplici e in rapida espansione.
Analisi e Redazione Documentale
I modelli basati su Transformer eccellono nell’analisi di documenti complessi. Un sistema potrebbe analizzare uno statuto societario di 50 pagine, identificare clausole potenzialmente problematiche, verificare la coerenza interna, e suggerire modifiche – tutto in pochi secondi. Utilizzando Chain of Thought prompting, possiamo ottenere non solo le conclusioni ma anche il ragionamento esplicito che ha portato a ciascuna raccomandazione.
Ricerca Giurisprudenziale e Normativa
Gli LLM possono processare enormi basi di dati giurisprudenziali, identificando precedenti rilevanti anche quando espressi con terminologia diversa da quella della query. L’attention mechanism permette al modello di cogliere analogie concettuali profonde, non solo sovrapposizioni lessicali.
Sistemi RAG (Retrieval-Augmented Generation)
Un’applicazione particolarmente promettente è l’integrazione di LLM con sistemi di retrieval che accedono agli archivi dello studio. Un notaio può chiedere: “Come abbiamo gestito l’ultima fusione transfrontaliera con una società portoghese?” Il sistema recupera i documenti rilevanti e li fornisce al modello come contesto, permettendo risposte informate dai precedenti dello studio.
Compliance e AML
I modelli MoE potrebbero avere esperti specializzati in anti-money laundering, sanzioni internazionali, fiscalità, diritto societario. Un sistema di questo tipo potrebbe analizzare una transazione immobiliare complessa, routing diversi aspetti agli esperti appropriati, e sintetizzando una valutazione del rischio complessiva.
Considerazioni Critiche: Limiti e Responsabilità
È essenziale mantenere una prospettiva critica. Gli LLM, per quanto impressionanti, hanno limitazioni fondamentali.
Mancanza di Comprensione Vera
Gli LLM sono straordinari pattern matchers, ma non “comprendono” nel senso umano. Non hanno modelli causali del mondo, non distinguono intrinsecamente tra fatto e finzione, non possiedono ragionamento deduttivo rigoroso. Sono strumenti statistici sofisticati, non intelligenze senzienti.
Allucinazioni e Affidabilità
I modelli possono “allucinare” – generare informazioni plausibili ma false con totale sicurezza. Per un notaio, utilizzare un output di un LLM senza verifica sarebbe una grave violazione deontologica. L’LLM può essere un assistente straordinariamente capace, ma la responsabilità finale rimane umana.
Privacy e Riservatezza
I dati inviati a API di modelli proprietari potrebbero essere utilizzati per training o altri scopi. Per documenti riservati, è essenziale utilizzare modelli deployati on-premise o assicurarsi che i contratti con i provider garantiscano la riservatezza.
Bias e Equità
Gli LLM riflettono i bias presenti nei loro dati di training. Un modello addestrato principalmente su giurisprudenza e dottrina di common law potrebbe performare male su questioni di civil law. È necessaria consapevolezza critica su questi limiti.
Conclusioni: Verso un’Intelligenza Aumentata
Il viaggio che abbiamo tracciato – da “Attention Is All You Need” fino agli LLM contemporanei, passando per Chain of Thought e Mixture of Experts – rappresenta una delle evoluzioni tecnologiche più rapide e profonde della storia recente.
Per i notai, queste tecnologie non rappresentano una minaccia esistenziale, ma un’opportunità di evoluzione. L’AI può gestire la ricerca in archivi immensi, identificare pattern e anomalie, generare bozze, suggerire formulazioni alternative. Ma il giudizio professionale, la comprensione del contesto sociale e umano, la responsabilità deontologica, rimangono dominio esclusivo dell’uomo.
Il futuro che si profila è quello dell’intelligenza aumentata: notai che utilizzano strumenti AI per amplificare le proprie capacità, dedicando più tempo al ragionamento di alto livello, al rapporto con i clienti, alla gestione di complessità genuina. Gli strumenti cambiano, ma la sostanza della professione – garantire certezza, sicurezza e legalità attraverso un’analisi attenta e responsabile – rimane invariata.
Conoscere le fondamenta tecnologiche di questi strumenti non è mero nozionismo. È un dovere professionale, proprio come un notaio deve conoscere le basi del diritto romano per comprendere i nostri istituti giuridici moderni. Il paper di Vaswani et al. non è solo un testo per informatici: è la chiave per comprendere la trasformazione che stiamo vivendo e per partecipare consapevolmente alla sua evoluzione.
Notaio Manlio Carlo Soldani
Studio: Via Camillo Prampolini n. 14, Domodossola
Iscritto al Collegio Notarile di Verbania
Email: domodossola@notaiosoldani.it
Tel: 0324 066077
Bibliografia Essenziale
Transformer e Architettura:
- Vaswani, A., Shazeer, N., Parmar, N., Uszkoreit, J., Jones, L., Gomez, A. N., Kaiser, Ł., & Polosukhin, I. (2017). Attention is all you need. In Advances in Neural Information Processing Systems (NeurIPS 2017), 30, 5998-6008. https://arxiv.org/abs/1706.03762
Chain of Thought Prompting:
- Wei, J., Wang, X., Schuurmans, D., Bosma, M., Ichter, B., Xia, F., Chi, E., Le, Q., & Zhou, D. (2022). Chain-of-thought prompting elicits reasoning in large language models. In Advances in Neural Information Processing Systems (NeurIPS 2022), 35. https://arxiv.org/abs/2201.11903
- Kojima, T., Gu, S. S., Reid, M., Matsuo, Y., & Iwasawa, Y. (2022). Large language models are zero-shot reasoners. In Advances in Neural Information Processing Systems (NeurIPS 2022), 35. https://arxiv.org/abs/2205.11916
Mixture of Experts:
- Shazeer, N., Mirhoseini, A., Maziarz, K., Davis, A., Le, Q., Hinton, G., & Dean, J. (2017). Outrageously large neural networks: The sparsely-gated mixture-of-experts layer. In International Conference on Learning Representations (ICLR 2017). https://arxiv.org/abs/1701.06538
- Fedus, W., Zoph, B., & Shazeer, N. (2021). Switch transformers: Scaling to trillion parameter models with simple and efficient sparsity. Journal of Machine Learning Research, 23(120), 1-39. https://arxiv.org/abs/2101.03961
Modelli Fondazionali:
- Radford, A., Narasimhan, K., Salimans, T., & Sutskever, I. (2018). Improving language understanding by generative pre-training. OpenAI. https://cdn.openai.com/research-covers/language-unsupervised/language_understanding_paper.pdf
- Devlin, J., Chang, M. W., Lee, K., & Toutanova, K. (2019). BERT: Pre-training of deep bidirectional transformers for language understanding. In Proceedings of NAACL-HLT 2019. https://arxiv.org/abs/1810.04805
- Raffel, C., Shazeer, N., Roberts, A., Lee, K., Narang, S., Matena, M., Zhou, Y., Li, W., & Liu, P. J. (2020). Exploring the limits of transfer learning with a unified text-to-text transformer. Journal of Machine Learning Research, 21(140), 1-67. https://arxiv.org/abs/1910.10683
- Brown, T., Mann, B., Ryder, N., Subbiah, M., Kaplan, J. D., Dhariwal, P., … & Amodei, D. (2020). Language models are few-shot learners. In Advances in Neural Information Processing Systems (NeurIPS 2020), 33, 1877-1901. https://arxiv.org/abs/2005.14165
Il presente articolo ha carattere generale e informativo, non costituisce parere legale personalizzato e non sostituisce la consulenza diretta con un notaio. Per assistenza specifica relativa alla vostra situazione, vi invitiamo a contattare il nostro Studio per fissare un appuntamento. Contenuto generato con sistemi di Intelligenza Artificiale e supervisionato da professionisti dello Studio Notarile, in conformità ai requisiti di trasparenza del Regolamento UE 2024/1689 (AI Act).